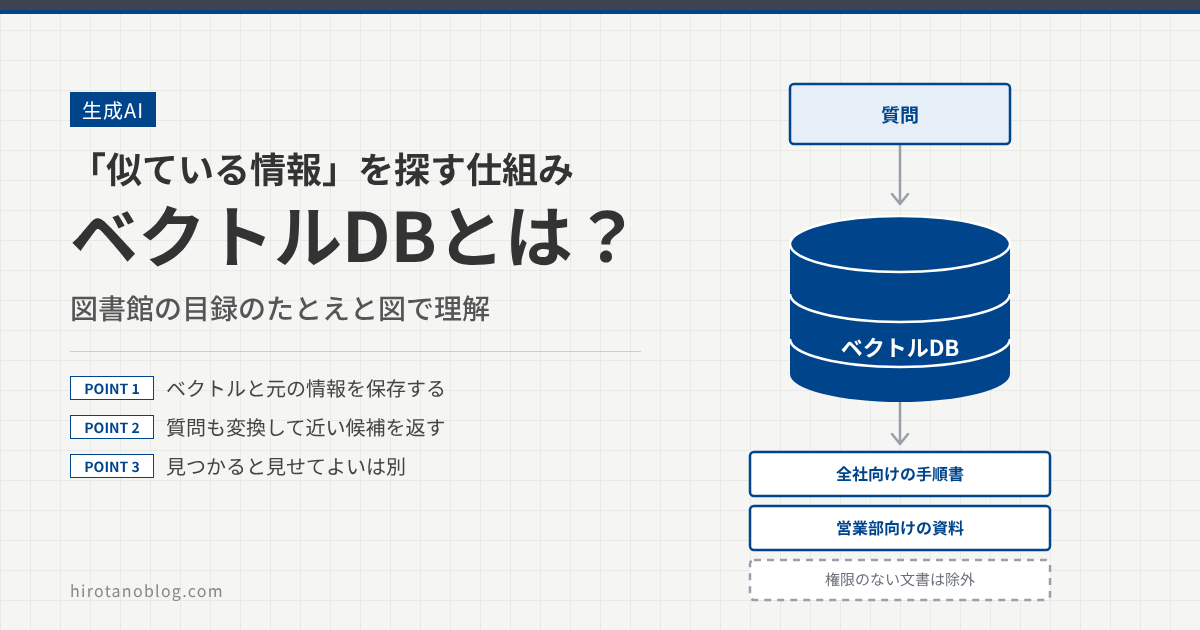
Embeddingで文章をベクトルにできることは、別の記事で扱いました。文書が何千、何万と増えると、そのベクトルを保存して、素早く探す仕組みが必要になります。それが「ベクトルDB(ベクトルデータベース)」です。この記事では、何を保存するのか、質問からどう候補を返すのか、うまくいかない原因や権限の扱いを、図で説明します。
- ベクトルDBは、文書の断片、ベクトル、参照元、メタデータを保存して、近いものを素早く探す仕組み
- 質問もEmbeddingに変換して近い候補を返す。この段階では、まだ回答文は作らない
- 「見つかる」と「見せてよい」は別で、権限による絞り込みを検索に組み込む必要がある
文書が増えると、似たもの探しが難しくなる
社内の文書が数十件なら、質問のたびにすべてのベクトルとコサイン類似度を計算しても、すぐに終わります。しかし、数万、数百万件になると、毎回すべてと比べる方法では時間がかかります。そこで、あらかじめ検索しやすい形で管理しておき、近いものだけを素早く取り出す、という発想が出てきます。
Pineconeの解説では、ベクトルDBを、埋め込みのベクトルを索引付けして保存し、高速な検索と類似検索を行うものと説明しています。また、近似的な結果を返す方式(近似最近傍検索、ANN)では、精度と速さのトレードオフになるとも述べています。一番近い文書を取りこぼす可能性と引き換えに、速く探します。
図書館の目録にたとえると、本を1冊ずつ棚から探す代わりに、内容の近さで引ける目録を作っておくようなものです。たとえは説明用で、実際の仕組みはこのあと説明します。
ベクトルDBに入れるもの
ベクトルDBには、ベクトルだけでなく、探したあとに使う情報も一緒に入れます。長い文書は、そのままでは1つのベクトルで表しにくいので、「チャンク」と呼ばれる断片に分けてから、断片ごとにベクトルにします。
| 項目 | 役割 |
|---|---|
| 文書の断片(チャンク) | 探したあとに読ませる、元の文章の一部 |
| ベクトル(Embedding) | 断片の内容を数値の並びにしたもの。近さを調べるために使う |
| 元文書への参照 | どの文書の、どこから取った断片かを示す。出典の表示や、元文書を開くときに使う |
| メタデータ | タイトル、部署、更新日、公開範囲など。絞り込みに使う |
Pineconeの解説では、ベクトルDBは各ベクトルにメタデータを保存でき、各ベクトルは元の内容への参照を保つとされています。保存の方法は製品や設計によって異なります。
断片の大きさも、結果に影響します。Microsoftのドキュメントは、Azure AI Searchでの出発点として、512トークン程度の断片と、25%程度の重なりを挙げています。ただし、最適な値は文書や用途によって変わるため、実際の文書で試して決めることになります。
質問から候補文書を返す流れ
ベクトルDBを使った検索は、文書を登録するときの流れと、質問が来たときの流れの2本に分けられます。
登録のときと検索のときで、同じEmbeddingモデルを使います。Pineconeの解説でも、質問は索引付けに使ったのと同じモデルでベクトルにしてから、保存済みのベクトルと比べて、近いものを探すと説明されています。Embeddingについての別の記事で書いたとおり、別のモデルのベクトルとは比べられません。
ここまでで返ってくるのは、近い順の「候補の文書(断片)」です。まだ、質問に対する回答文は作られていません。探した候補をAIに渡して答えさせる仕組み(RAG)については、別の記事で扱います。
キーワード検索や絞り込みも役立つ
ベクトル検索は、言い換えに強い一方で、型番や固有名詞のように、一字一句の一致が大事な語は、単語の一致で探す方法のほうが向くことがあります。そこで、ベクトル検索とキーワード検索を組み合わせます。Microsoftのドキュメントは、これを「ハイブリッド検索」と呼び、2つを同じリクエストで並行して実行し、結果を統合して順位付けする方法だと説明しています。単独で使うより、良い結果になることが多いとも述べられています。
さらに、メタデータで絞り込むこともできます。たとえば、部署が営業の文書だけ、更新日が今年の文書だけ、という条件を付けます。Microsoftのドキュメントでは、絞り込みはベクトル検索の前に行うことも、後に行うこともでき、Pineconeの解説も、どちらの方法にも性能面の影響があるとしています。
| 方法 | 向いていること |
|---|---|
| ベクトル検索 | 言い換えや、表現が違う同じ話題を探す |
| キーワード検索 | 型番、固有名詞、エラーコードなど、一致が大事な語を探す |
| メタデータの絞り込み | 部署、日付、公開範囲などの条件で、対象を限定する |
検索がうまくいかない主な理由
ベクトルDBを入れても、思った文書が出てこないことがあります。原因は、1つとは限りません。主なものを、確認することと合わせて並べます。
| 原因 | 起こること | 確認すること |
|---|---|---|
| 文書の区切り方 | 断片が大きすぎて話題が混ざる。小さすぎて文脈が切れる | 断片の大きさ、区切りの重なり。Microsoftは、重なりを入れると文脈が続きやすくなると説明している |
| 古いデータ | 文書を更新・削除しても、DB側が古いままだと、古い内容が候補に出る | 文書の更新や削除が、DBにも反映されているか |
| 曖昧な質問 | 質問が短く条件がないと、的外れな候補が上位に出ることがある | 対象や条件を足して質問し直す。絞り込み条件を使う |
| 権限設定の不足 | 本来、見せてはいけない文書が候補に入る | 質問者ごとの絞り込みが、検索に組み込まれているか |
「見つかる」と「見せてよい」は別
検索で見つかった文書が、質問した人に見せてよい文書だとは限りません。たとえば、営業部の社員の質問に対して、人事部だけが見られる評価資料が候補に入ると、問題になります。
MicrosoftのAzure AI Searchでは、各文書に「見てよいグループ」の情報を持たせ、検索のたびに、質問者が所属するグループで絞り込む方法(セキュリティトリミング)が紹介されています。注意点として、このしくみは質問者が本当にそのグループかどうかを確かめるものではなく、アプリ側で正しくグループを取得する必要があります。また、すべての検索に絞り込みを付けなければ、絞り込まれていない結果が返ります。
OWASPも、ベクトルや埋め込みの保存先でアクセス制御が不十分だと、機密情報を含む埋め込みへの不正なアクセスにつながると指摘しています。対策として、きめ細かなアクセス制御と、権限を意識したベクトルDBを使うことや、利用者グループごとにデータを分けることを挙げています。
候補はあとでAIに渡され、返答の中に含まれて見えてしまうことがあります。このため、返答で隠すのではなく、検索の段階で、見せてはいけない文書を候補から外すことが大切です。AIでの情報漏えいへの対策については、別の記事で扱います。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| ベクトルDB | ベクトルを保存し、近いものを素早く探すデータベース |
| チャンク | 長い文書を分けた断片。断片ごとにベクトルにする |
| メタデータ | タイトル、部署、更新日、公開範囲など、文書についての付帯情報 |
| 近似最近傍検索(ANN) | 一番近いものを厳密に探すのではなく、近いものを速く探す方法。精度と速さのトレードオフがある |
| ハイブリッド検索 | ベクトル検索とキーワード検索を組み合わせ、結果を統合する検索 |
| セキュリティトリミング | 質問者の権限に合わせて、見せてよい文書だけに検索結果を絞り込むこと |
コメント