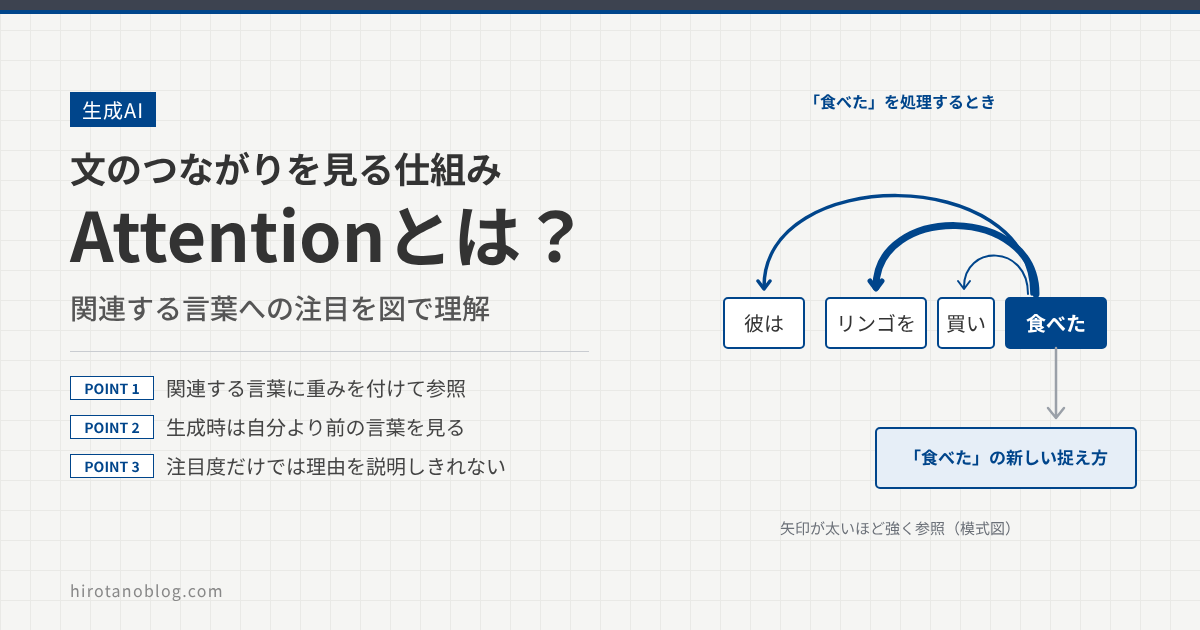
「彼はリンゴを買い、食べた」。この「食べた」の対象がリンゴだと分かるのは、前の言葉を手掛かりにしているからです。LLMも、文章を処理するとき、周りの言葉のどれを手掛かりにするかを選んでいます。その仕組みが、Attention(アテンション)です。
この記事では、Attentionを数式を使わずに図で説明します。トークン(文章の小さな区切り)は別の記事で扱っているため、ここでは分かりやすいように、単語を単位にして示します。
- Attentionは、ある言葉を処理するときに、文中の関連する言葉を重み付けして参照する仕組みであること
- Query・Key・Valueの3つの役割と、複数の視点で同時に見るマルチヘッドAttentionのイメージ
- Self-Attention(同じ文の中を見る)と、Self以外のAttention(別の文を見る)の違い
- 長い入力では必要な情報を取り逃すことがあり、言葉どうしの組み合わせがn²で増えること
同じ言葉でも、前後で意味が変わる
英語の「bank」は、「銀行」の意味にも「川岸」の意味にもなります。どちらの意味なのかは、bankという言葉だけでは決まらず、周りの言葉で決まります。
「deposited(預けた)」や「cash(現金)」があれば銀行、「fished(釣りをした)」や「river(川)」があれば川岸だと判断できます。文章を理解するには、ある言葉を、周りの言葉との関係の中で捉える必要があります。LLMがこの関係を扱うために使っている仕組みがAttentionです。
会話の中で「それ」が何を指すのかを、前の発言を見返して確かめる動きに似ています。ただし、AIのAttentionは計算の仕組みであり、人間の注意力と同じものではありません。たとえは仕組みそのものではなく、イメージです。
注目先は、処理する言葉によって変わる
「彼はリンゴを買い、食べた」で考えます。「食べた」を処理するときは、「何を食べたのか」を示す「リンゴを」が重要な手掛かりです。一方、「買い」を処理するときは、「誰が買ったのか」を示す「彼は」が手掛かりになります。
このように、注目先は固定ではなく、処理する言葉ごとに変わります。図の矢印の太さは、強く参照するほど太くしています。実際の強さはモデルが計算で決めるもので、図は説明用の模式図です。
図の「買い」を処理するときに「食べた」が灰色なのは、文章を生成するLLMでは、後ろの言葉を参照しないためです。この理由は、あとで説明します。
Attentionは関連する部分を重み付けする
Attentionでは、ある言葉が、文中の各言葉に対して「どれだけ関係があるか」を計算します。この関係の強さを「重み」と呼びます。重みは、すべて足すと100%になるように調整されます。そして、重みに応じて各言葉の情報を混ぜ合わせ、その言葉の新しい捉え方を作ります。
1か所だけを見るのではなく、複数の言葉を、それぞれ違う強さで同時に参照する点が特徴です。
Query・Key・Valueのイメージ
Attentionの計算には、Query(クエリ)、Key(キー)、Value(バリュー)という3つの役割が出てきます。名前は難しく見えますが、検索にたとえると整理しやすくなります。
| 論文での呼び方 | 検索にたとえると | 役割 |
|---|---|---|
| Query(クエリ) | 検索キーワード(問い) | いま処理している言葉が、何を手掛かりにしたいか |
| Key(キー) | 見出し・タグ(札) | 各言葉が、どんな手掛かりになれるか。Queryと比べて、関連の強さを決める |
| Value(バリュー) | 本文(中身) | 参照したときに、実際に受け取って混ぜ合わせる情報 |
計算は、次の3段階です。1つ目に、QueryとKeyを比べて、どの言葉が手掛かりになりそうか(一致度)を出します。2つ目に、一致度を、合計100%の重みに直します。3つ目に、その重みに応じてValueを混ぜ合わせます。
KeyとValueが分かれているのは、「誰を参照するかを決めるための札」と、「参照したときに受け取る中身」を、別々に持たせるためです。論文でも、Attentionは「queryと、key・valueの組を、出力に対応づけるもの」で、出力はvalueの重み付きの和だと説明されています。
Self-Attentionでは、1つの言葉が3つの役割をすべて持ちます。自分が処理されるときはQueryを出し、他の言葉から参照されるときはKeyとValueを差し出します。
図の「食べ物」や「何を食べた?」は、イメージをつかむための説明です。実際のQuery・Key・Valueは、学習によって自動的に作られる数値のまとまりで、人が読める言葉の札が付いているわけではありません。
マルチヘッドAttention:複数の視点で同時に見る
Attentionを1回だけ行うと、1通りの見方しかできません。そこで、見る視点を変えたAttentionを複数並べて同時に行い、結果を合わせる方式が、マルチヘッドAttentionです。「ヘッド」は、1つ1つのAttentionのことです。
論文では、複数のヘッドによって、異なる見方の情報に、異なる位置で同時に注目できると説明されています。論文のモデルでは、8個のヘッドを並べています。図の「何を」「誰が」「動作」は説明用の観点で、実際に各ヘッドが何を見るかは、学習の中で決まります。
論文の付録には、代名詞の「its」が何を指すのかの処理に関わっているように見えるヘッドの例が、図で示されています。
Self-Attentionと、Self以外のAttention
Attentionは、Query・Key・Valueを、どこから作るかで2種類に分けて考えられます。
| 種類 | Queryの出どころ | Key・Valueの出どころ | 見ているもの |
|---|---|---|---|
| Self-Attention(自己注意) | 同じ文 | 同じ文 | 同じ文の中の、言葉どうしの関係 |
| Self以外(クロスアテンション) | 出力側の文 | 入力側の文 | 別の文との関係 |
Self以外のAttentionの例は、翻訳です。論文の翻訳モデルでは、出力(日本語など)を作る側がQueryを出し、元の文を読む側のKeyとValueを参照します。これは論文では「encoder-decoder attention」と呼ばれ、一般にはクロスアテンションとも呼ばれます。図では、出力側の「リンゴを」を作るときに、元の文の「apple」を強く参照しています。
一方、続きの文章を生成するLLM(decoder-onlyのモデル)には、別に読む入力側がありません。入力した文章と、生成した文章を1つの並びとして扱うため、Self-Attentionが使われます。
Transformerの位置付け
Transformerは、2017年の論文で提案されたモデル設計です。それまで使われていた再帰型や畳み込みのネットワークを使わず、Attentionだけを中心に作られている点が特徴で、並列で計算しやすく、学習の時間も短くできると報告されました。現在のLLMの多くは、このTransformerをもとにしています。
1つの層は、文脈を集めるSelf-Attentionと、各位置ごとの変換で構成されます。この層を何層も重ねて、次のトークンの候補を出します。論文のモデルでは、6層を重ねています。
文章を生成するLLMでは、ある言葉を処理するとき、自分より前の言葉だけを参照します。文章は前から順に作られ、後ろの言葉はまだ存在しないためです。論文でも、出力を作る側では、後ろの言葉の情報が前へ流れ込まないように、そうした接続を使えなくする処理(マスク)を入れたと説明されています。
長い入力でも必要な情報を取り逃すことがある
Attentionがあっても、長い入力の中のすべての情報が確実に使われるわけではありません。トークンとコンテキストウィンドウの記事でも触れたとおり、必要な情報が入力の中ほどにあると使われにくくなる傾向(Lost in the Middle)や、入力が長いほど正確さが下がる傾向が報告されています。
仕組みの面から見ると、重みの合計は常に100%なので、参照先が増えるほど、1つあたりの重みは平均して小さくなります。
長い資料を渡すときは、必要な部分に絞り、重要な条件を目立つ位置にも書くといった工夫が有効です。
なぜ、組み合わせが n² 個になるのか
Attentionでは、各言葉が、文中の言葉それぞれとの関係を計算します。言葉がn個あると、1つの言葉がn個を相手にするので、全体ではn × n = n²通りの組み合わせになります。
図は、縦が処理する言葉、横が参照先の言葉で、1マスが組み合わせ1つです。言葉が3個なら9通り、6個なら36通り、12個なら144通りです。個数が2倍になると、組み合わせは4倍になります。目安として、1,000個なら約100万通り、10,000個なら約1億通りです。
実際に文章を生成するLLMは、前の言葉しか参照しないため、数える組み合わせは約半分になります。それでも、入力が2倍になると約4倍になる増え方は変わりません。つまり、長い入力ほど、計算の負担は急に重くなります。Hugging Faceのドキュメントでも、多くのTransformerモデルは、Attentionの表が正方形になる「full attention」を使うため、長い文章では大きな計算上の負担になると説明されています。そのため、近くの言葉を中心に見るなど、計算を減らす工夫も提案されています。
なお、n²は計算量の増え方の話です。Anthropicは、この構造を、長い入力で精度が下がる現象の背景として挙げていますが、原因が実験で特定されたわけではありません。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| Attention | ある言葉を処理するときに、関連する言葉を重み付けして参照し、情報を混ぜ合わせる仕組み |
| 重み | 参照先ごとの関連の強さ。合計が100%になるように調整される |
| Query・Key・Value | 問い・見出し・中身。QueryとKeyを比べて重みを決め、その重みでValueを混ぜる |
| マルチヘッドAttention | 見る視点を変えて、Attentionを複数並べて行い、結果を合わせる方式 |
| Self-Attention | 同じ入力の中の言葉どうしで関係を見るAttention |
| クロスアテンション | 別の入力(翻訳の元の文など)を参照するAttention。論文ではencoder-decoder attention |
| Transformer | Attentionを中心にしたモデル設計。現在のLLMの多くが、これをもとにしている |
| マスク | 文章を生成するときに、後ろの言葉を参照できないようにする処理 |
コメント