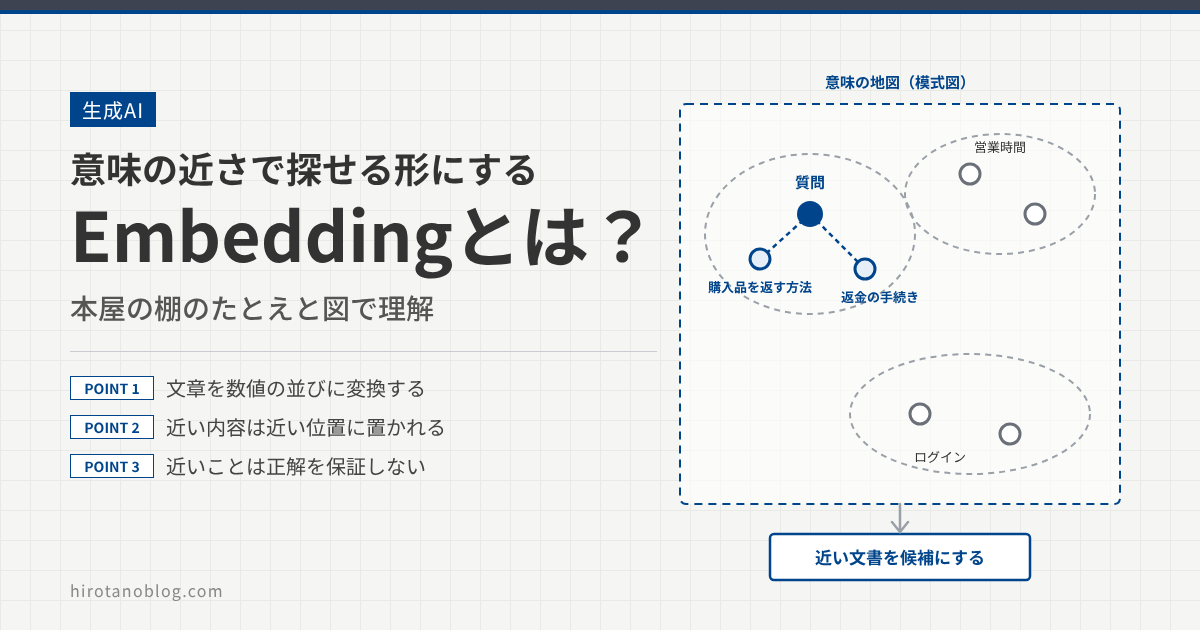
AIに文章を探させたり、社内の資料から関連する内容を見つけさせたりする話で、よく「Embedding(埋め込み)」という言葉が出てきます。この記事では、Embeddingが何をするものなのか、なぜ「意味の近さ」で探せるのかを、図で順に説明します。
- Embeddingは、文章を数値の並び(ベクトル)に変換する仕組み
- 意味の近い文章は近い位置に置かれ、その近さは高校で習う内積(コサイン類似度)で測れる
- 近いことは正解を保証せず、使うモデルによって近さも変わる
キーワードが違っても、同じ話題を探したい
「返品したい」と質問したとき、手元の資料に「購入品を返す方法」という文書があるとします。2つの文には、同じ単語がほとんどありません。単語の一致で探す方法では、この文書は見つかりにくくなります。
人間は、この2つが同じ話題だとすぐ分かります。そこで、単語の一致ではなく、内容の近さで探したい、という需要が出てきます。そのために使われるのが Embedding です。
本屋にたとえると、題名が違っていても、近いテーマの本が同じ棚の隣に並んでいるようなものです。Embeddingは、文章をそのような「棚の位置」に置くための変換です。たとえは説明用で、実際の仕組みは次の節のとおり数値で表します。
Embeddingは文章をベクトルに変換する
OpenAIのドキュメントは、embedding(埋め込み)を、浮動小数点数の並び(ベクトル)と説明しています。2つのベクトルの距離は、2つの文章の関連の強さを表します。Hugging Faceの解説でも、文章などを数値で表したもので、モデルが作るベクトルの長さは常に同じだとされています。
ベクトルの長さ(次元数)はモデルによって決まります。OpenAIの text-embedding-3-small は既定で1536個、text-embedding-3-large は3072個です。多くの場合、数字の1つ1つが何を表しているのかを、人が読み取ることはできません。たとえば 0.12 という数字だけを見ても、それが何を意味するのかは分かりません。大事なのは数字全体の組み合わせで、ほかの文章のベクトルと比べたときに、どれだけ近いかを測ります。
Claudeのような文章を作るモデルとは別に、Embedding専用のモデルがあります。Anthropicのドキュメントによると、Anthropicは自社のEmbeddingモデルを提供しておらず、Voyage AIなどの提供元を案内しています。
「意味の近さ」はどうイメージする?
ベクトルは、座標を並べたものと考えると分かりやすくなります。2次元なら点が1つ決まり、似た内容の文章を近い位置に置くと、次のような地図になります。
質問も文書も、同じ方法でベクトルにすれば、この地図の上に並べられます。質問に近い点にある文書を選ぶと、「返品」「返金」に関する文書が候補に入ります。営業時間やログインに関する文書は、遠くにあるので入りません。
ただし、この図は模式図です。実際のベクトルは数百〜数千の次元を持つため、人が図に描いて確かめることはできません。2次元の図は、考え方を伝えるための絵として見てください。
「近い」「遠い」を具体的な数値で測る方法は、次の節で説明します。
近さはどう測る?コサイン類似度
ここまで「近い」「遠い」と書いてきましたが、コンピュータは、ベクトルどうしの近さを数値で計算します。代表的な方法が、高校の数学で習ったベクトルの内積を使う「コサイン類似度」です。2つのベクトルの「向き」がどれだけそろっているかを、-1から1の値で表します。OpenAIのドキュメントも、検索の例で、質問と各文書のベクトルのコサイン類似度を使っています。
向きがそろっているほど1に近く、直角なら0、反対向きなら-1になります。以下で、高校で習った内容を思い出しながら、順に確かめます。
高校で習った内積のおさらい
高校では、2つのベクトル a、b の内積を、次の2通りで習ったと思います。
| 見方 | 式 |
|---|---|
| 成分で計算する | a = (a₁, a₂)、b = (b₁, b₂) のとき、a・b = a₁b₁ + a₂b₂ |
| 向きで計算する | a・b = |a||b|cosθ(θは2つのベクトルのなす角、|a|は長さ) |
2つ目の式を変形すると、cosθ = a・b ÷ (|a||b|) になります。これがコサイン類似度です。内積を、2つのベクトルの長さの積で割ることで、長さの影響を取り除き、向きだけを比べています。
例として、a = (3, 1)、b = (2, 1) で計算します。
結果は約0.99で、ほぼ同じ向きです。文章のベクトルは1536個のような長い数字の並びですが、各成分の積をすべて足して内積を求め、長さで割る計算は同じです。2次元と違って図には描けませんが、同じ式で計算できます。
似ているとき・似ていないとき
同じ a = (3, 1) に対して、b を変えてみます。
| b | 内積 | cosθ | 向き |
|---|---|---|---|
| (2, 1) | 7 | 約0.99 | ほぼ同じ向き。内容が似ているイメージ |
| (-1, 3) | 0 | 0 | 直角。関係が薄いイメージ |
| (-3, -1) | -10 | -1 | 反対向き |
文章のEmbeddingでは、-1に近い値が、そのまま「反対の意味」を表すとは限りません。また、どの値から「似ている」と判断するかは、使うモデルや文書によって変わり、一律の基準はありません。実際には、値そのものよりも、複数の候補の値を比べて、大小で順位を付けて使います。
内積・類似度をどう使うか
検索では、質問をベクトルにして、各文書のベクトルとのコサイン類似度を計算します。値が大きい順に並べ、上位のいくつかを候補にします。
ベクトルの長さを1にそろえる(正規化する)と、長さで割る必要がなくなり、内積がそのままコサイン類似度になります。Anthropicのドキュメントでは、Voyage AIのEmbeddingは長さ1に正規化されていて、内積とコサイン類似度が同じになると説明されています。計算が単純になります。
近さを測る方法には、距離で測るものもありますが、この記事では、OpenAIの例で使われているコサイン類似度を中心に説明しました。
近いことと、同じ答えであることは別
コサイン類似度が高いと分かるのは「近い内容かどうか」までです。質問に対する正しい答えが、その文書に書かれているかどうかは、別の問題です。
たとえば「この商品は返品できますか」という質問には、「返品できない商品の一覧」も近い文書として上がってきます。話題が同じだからです。答えが「できる」なのか「できない」なのかは、文書の中身を読んで確かめる必要があります。
否定表現には、特に注意が必要です。NevIRという研究では、否定だけが違う2つの文書を並べ替えさせる課題で、最新のものを含む多くの検索モデルが、否定を考慮せず、ランダムな並べ替えと同じか、それ以下の結果だったと報告されています。この研究は2023年のもので、現在のモデルで同じとは限りません。自分が使うモデルで確かめる必要があります。
専門用語や社内用語も同様です。モデルがその言葉をあまり学んでいなければ、近さの判断がずれることがあります。
Embeddingはどこで使う?
OpenAIのドキュメントは、Embeddingの使い道として、検索、クラスタリング、おすすめ、異常検知、多様性の測定、分類を挙げています。Hugging Faceの解説には、言い換えの検出も挙がっています。
| 使い道 | 何をするか |
|---|---|
| 類似文書検索 | 質問に近い文書を探す。言い換えでも見つけやすい |
| 言い換え・重複の検出 | ほぼ同じ内容の文章を見つけ、まとめたり除いたりする |
| 分類の補助 | 既に分かっている例に近いかどうかで、種類を振り分ける |
| クラスタリング | 近い文章どうしをグループにまとめる |
| おすすめ | 読んだものに近い内容を提示する |
大量の文書をベクトルにして保存し、素早く探す仕組みは、別の記事で扱います。そこで、探した文書をAIに渡して答えさせる使い方(RAG)にもつながります。
モデルによって「近さ」は変わる
どのEmbeddingモデルを使うかで、ベクトルも、近さの判断も変わります。Googleのドキュメントは、gemini-embedding-001 と gemini-embedding-2 のベクトルの空間は互換性がないと説明しています。別のモデルで作ったベクトルどうしは、混ぜて比べられません。
| 確認すること | 理由 |
|---|---|
| どのモデルか | モデルが変わると、ベクトルも近さも変わる。保存済みのベクトルを作り直す必要が出ることもある |
| 対象の言語・文書 | モデルによって得意な言語や用途が違う。日本語や社内文書で試して確かめる |
| 入力の種類 | 質問用と文書用を区別するモデルがある(Voyage AIの input_type、Geminiの task_type など) |
| 次元数 | 多いほど良いとは限らない。Googleは、性能は次元数の大きさだけでは決まらないと説明している |
公開されている比較(MTEBなど)は、モデルを選ぶときの手がかりになります。ただ、自分の文書や言い回しで、期待どおりに近い文書が上がってくるかは、実際に試さないと分かりません。
次元数を減らして使う場合は、ベクトルの長さをそろえる処理(正規化)が必要なことがあります。OpenAIのドキュメントは、次元数を手動で変えるときは正規化するよう説明しています。GoogleのEmbeddingモデルでも、モデルによって、自動で正規化されるものと手動で行うものがあります。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| Embedding(埋め込み) | 文章などを、数値の並び(ベクトル)で表したもの。また、その変換 |
| ベクトル | 数値の並び。Embeddingでは、同じモデルなら長さが一定 |
| 次元数 | ベクトルの長さ。モデルごとに異なる(例:1536、3072) |
| 類似度 | 2つのベクトルがどれだけ近いかを表す値 |
| 内積 | 2つのベクトルの対応する成分を掛けて足した値。a・b = |a||b|cosθ |
| コサイン類似度 | 内積を2つの長さの積で割った値(cosθ)。向きの近さを-1〜1で表す |
| Embeddingモデル | 文章をベクトルに変換する専用のモデル。文章を作るモデルとは別 |
| 意味検索 | 単語の一致ではなく、内容の近さで文書を探す方法 |
コメント