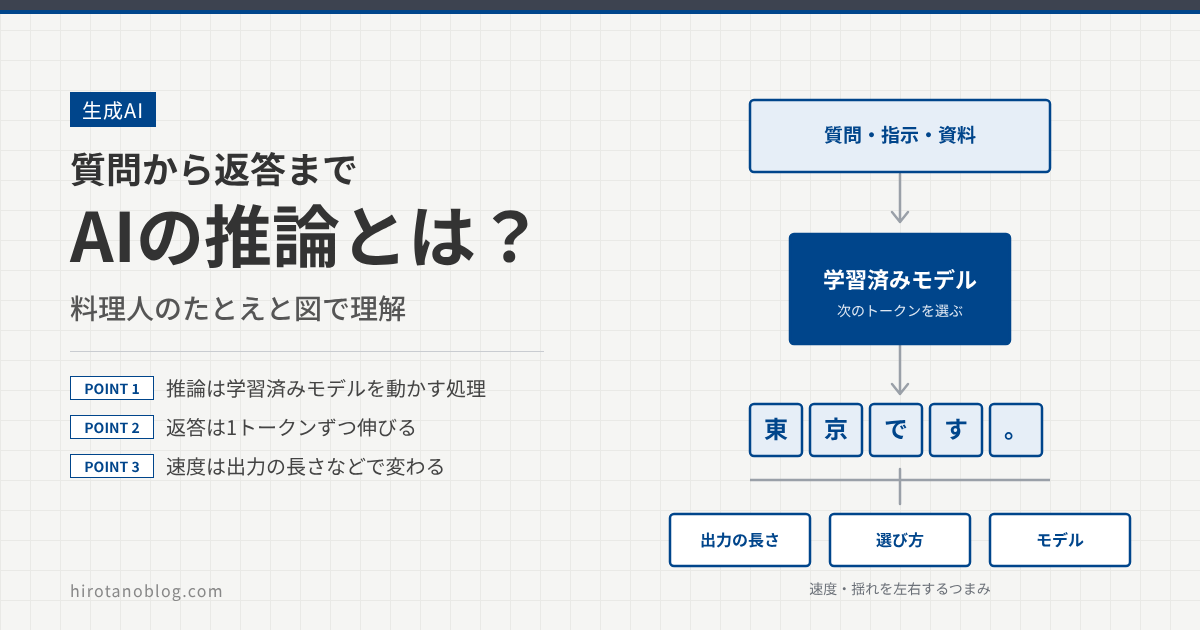
AIの話では「推論」という言葉がよく出てきますが、日常で使う「推論」とは少し意味が違います。この記事では、AI分野の「推論」が何をする処理なのか、質問を送ってから返答が出るまでに何が起きているのかを、図で順に追います。
- 推論は、学習済みのモデルを動かして、入力から出力を作る処理
- 返答は、次のトークンを選ぶ作業を、止まるまで繰り返してできる
- 速度や料金は出力の長さなどに左右され、画面の途中表示は内部処理そのものではない
AI分野の「推論」は、学習済みモデルを使う処理
AIの仕組みには、大きく分けて「学習」と「推論」の2つの段階があります。学習は、大量のデータをもとに、モデルの中身(パラメータ)を調整してAIを作る段階です。推論は、完成した学習済みモデルに入力を渡して、出力を作らせる段階です。NVIDIAも、推論を、学習済みのAIモデルが新しいデータに対して出力を生成する処理と説明しています。
料理にたとえると、料理人がレシピを身に付ける段階が学習、注文を受けて一皿作る段階が推論です。ChatGPTやClaudeなどに質問を送り、返答が返ってくるときに裏で動いているのは、この推論です。
通常、推論の間は、学習済みモデルの中身は書き換えられません。会話の内容を覚えているように見えるのは、それまでの履歴が毎回の入力に含まれているためで、モデルがその場で学習し直しているわけではありません。
「論理的に考える」の推論と混同しない
日本語の「推論」は、前提から筋道を立てて結論を導くこと(英語の reasoning)を指すことが多く、AI用語の inference とは別の言葉です。AIの文脈で「推論」と言うときは、多くの場合、学習済みモデルを実行して出力を得ること(inference)を指します。
紛らわしいのが「推論モデル」という呼び方です。これは、答える前に内部で考える文章(思考)を作るタイプのモデルを指すことが多く、名前や仕組みはサービスごとに異なります。考えるタイプのモデルも、実行時には、同じようにトークンを順に作って動いています。Claudeのドキュメントでも、思考に使われたトークンは出力トークンとして課金されると説明されています。
入力から返答までを順に追う
質問を送ってから返答が出るまでを、4つの段階に分けて追います。
| 段階 | 何をするか |
|---|---|
| 1 入力をまとめる | システムプロンプト、会話の履歴、参考資料、今回の質問などを、1つの入力にまとめる |
| 2 トークンに分ける | 入力の文字列を、モデルが扱う単位であるトークンの列にする |
| 3 次のトークンを選ぶ | 入力全体をもとに、次に来るトークンの候補を出し、その中から1つ選ぶ |
| 4 止めるか判断する | 終了の印が出た、または上限に達したら止める。そうでなければ、選んだトークンを足して3に戻る |
3と4は、返答が終わるまで繰り返されます。Hugging Faceのドキュメントは、LLMは、プロンプトと自分がそれまでに生成した出力をもとに、次のトークンを生成するように訓練されていて、決められた長さか、終了を表すトークン(EOS)に達するまで続くと説明しています。
止まり方には、モデルが自然に答え終わる場合のほかに、上限に達した場合や、指定した文字列が出た場合があります。Claude APIでは、それぞれ end_turn、max_tokens、stop_sequence という停止の理由として区別されます。
出力の揺れを左右する設定
手順3の「候補から1つ選ぶ」ときの選び方は、サービスによっては設定で変えられます。代表的なのが Temperature です。同じ質問でも返答が毎回少し違うのは、多くのサービスで、候補の中から選ぶ際にランダムさが入っているためです。
| 設定 | 意味 |
|---|---|
| Temperature | 返答に加えるランダムさ。Claude APIでは0.0〜1.0で、既定は1.0。分析や選択式の課題では0.0に近く、創作では1.0に近くするとよいとされている |
| top_p | 確率の高い候補から順に足していき、合計が指定した値に達するところまでを候補にする方法(nucleus sampling) |
最大出力トークン数(max_tokens) | 生成するトークンの上限。上限より前に終わることもある |
停止文字列(stop_sequences) | 指定した文字列が出たら生成を止める |
Temperatureを低くしても、事実の正しさは保証されません。変わるのは候補の選び方で、モデルが持っている知識や、入力に書かれた内容の正しさは変わらないためです。Claude APIの説明でも、Temperatureを0.0にしても結果は完全には固定されないとされています。
また、これらの設定をいつでも変えられるとは限りません。Claude APIでは、Claude Opus 4.6より後に出たモデルで、temperature、top_p、top_kを自由に変えられなくなっています。チャット画面では、そもそも設定できないサービスが多くあります。
速度やコストは何に左右される?
返答が出るまでの時間は、入力を処理する段階と、出力を1つずつ作る段階に分けて考えると整理できます。NVIDIAは、前者を prefill(入力トークンを処理する段階)、後者を decode(出力トークンを1つずつ順に生成する段階)と呼んで区別しています。
| 要因 | 影響のしかた |
|---|---|
| 出力の長さ | 出力は1つずつ作るため、長いほど時間がかかりやすい。OpenAIは、出力トークンを半分にすると遅延も約半分になることがある、という目安を示している |
| 入力の長さ | 長いほど処理は増えるが、遅延への影響は出力ほど大きくないことが多い。OpenAIは、プロンプトを半分にしても、遅延の改善は1〜5%程度にとどまることがあるとしている |
| モデルの大きさ | OpenAIは、処理速度に影響する主な要因はモデルの大きさだと説明している |
| システム構成 | 使うGPUの性能や、そのときの混み具合などでも変わる |
料金も、多くのAPIでは、入力と出力のトークン数をもとに決まります。ただし、単価や料金体系はサービスごとに異なり、チャットアプリでは月額制のものもあります。考えるタイプのモデルでは、内部で作られた思考のトークンも出力として数えられます。
表の数値は、あくまで各社が示す一般的な目安です。実際の速度は、モデルや混み具合、入力と出力の内容によって変わります。
体感の待ち時間を短くする方法として、ストリーミングがあります。これは、返答が完成するのを待たず、できた部分から順に画面へ表示する方式です。OpenAIは、待ち時間を短く感じさせるのに最も効果的な方法の1つとして挙げています。
「考えているように見える」表示の扱い
チャット画面で「考え中…」と表示されたり、文字が少しずつ現れたりすると、AIが頭の中で考えているように見えます。ただし、これらは画面上の表示で、モデル内部の処理をそのまま見せているとは限りません。
- 文字が順に出るのは、ストリーミングで、生成されたトークンから順に表示しているためです。
- 思考が表示される場合も、Claude APIでは、返ってくるのは思考の要約で、元の思考そのものではないと説明されています。料金は、要約ではなく、実際に生成された思考のトークン全体にかかります。
- モデルによっては、思考の文章を返さない設定が既定になっています。
表示のしかたは、サービスごとに異なります。画面に出た文章を、AIの本当の思考過程と受け取らず、「内部の処理を説明するための表示」として見ておくと、誤解が減ります。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| 学習 | 大量のデータをもとに、モデルのパラメータを調整してAIを作る段階 |
| 推論(inference) | 学習済みモデルに入力を渡し、出力を作らせる段階。質問を送って返答が返るときに動いている |
| トークン | モデルが文章を扱う単位。返答は1トークンずつ作られる |
| Temperature | 候補から選ぶときのランダムさを調整する設定。事実の正しさは保証しない |
| 最大出力トークン数 | 1回の返答で生成するトークンの上限 |
| ストリーミング | 返答の完成を待たず、できた部分から順に表示する方式 |
| 推論モデル | 答える前に、内部で思考の文章を作るタイプのモデル。呼び名や見せ方はサービスごとに異なる |
推論と学習、入力の処理と出力の生成
- NVIDIA:AI Inference(推論の定義、学習との違い)
- NVIDIA:Mastering LLM Techniques: Inference Optimization(prefillとdecode)
- Hugging Face:Generation with LLMs(次のトークンを順に生成し、終了トークンまたは上限で止まる)
設定・停止・ストリーミング・思考の表示
- Claude API:Create a Message(temperature、top_p、max_tokens、stop_sequencesの説明)
- Claude Docs:Handling stop reasons(end_turn、max_tokens、stop_sequence)
- Claude API:Streaming Messages(生成された内容を順次受け取る方式)
- Claude Docs:Thinking(思考の要約、表示の設定、課金)
速度
コメント