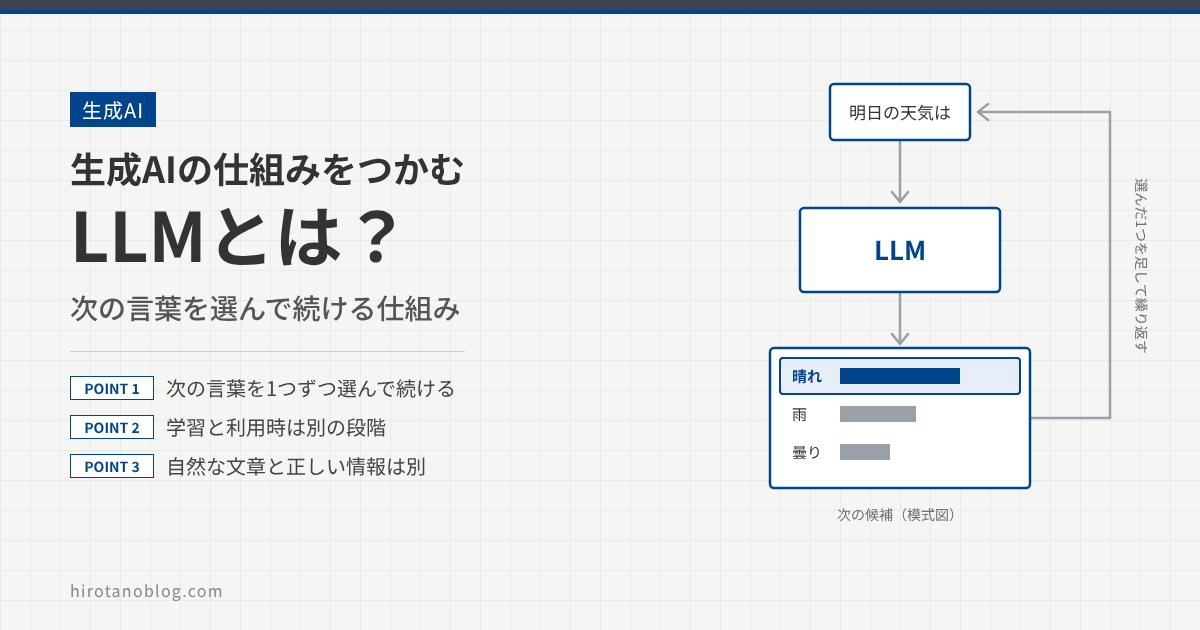
ChatGPTやClaudeのようなAIチャットに質問すると、人が書いたような文章が返ってきます。その裏側で動いているのがLLM(大規模言語モデル)で、基本の仕組みは「入力された文章の続きを、少しずつ作っていく」ことです。
この記事では、LLMがどのように文章を続けるのか、その力をいつ身に付けるのか、そして自然な文章と正しい情報がなぜ別物なのかを、図を使って順に見ていきます。数式やプログラミングの知識は要りません。
- LLMは、入力の続きを小さな区切り(トークン)単位で1つずつ選び、文章にしていること
- 文章のパターンを身に付ける「学習」と、質問に答える「利用時」は別の段階であること
- 自然な文章であることと、内容が正しいことは別であること
生成AIは、どんな仕事をしている?
生成AIは、文章、画像、音声などを新しく作るAIの総称です。この記事で扱うのは、そのうち文章を扱うものです。チャットでの質問応答、長文の要約、メール文面の作成は、見た目は違っても、入力を受け取って文章を出力するという点で共通しています。
入力にあたるのは、質問や指示、要約したい資料などです。出力は、それに対する返答の文章です。この入力と出力の間で働いているのが、LLMです。
LLMは大量の文章からパターンを学ぶ
LLMはLarge Language Model(大規模言語モデル)の略です。大量の文章を読み込み、言葉がどんな順序で並びやすいかというパターンを学んだモデルを指します。
学習した文章をそのまま取り出して返す仕組みではありません。言葉の並び方の傾向をもとに、入力に合わせて新しい文章を組み立てます。ただし、学習に使った文章に近い内容が出力に現れることもあります。
「次に来るもの」を選ぶと文章になる
「明日の天気は」と入力されたとします。続きとしてあり得る言葉は、「晴れ」「雨」「曇り」など複数あります。LLMは、入力された文脈をもとに、こうした候補それぞれがどれだけ続きとして自然かを計算し、その中から1つを選びます。
候補の顔ぶれと自然さは、文脈によって変わります。「明日の天気は」の前に「来週の旅行の予定を立てています。」という文があれば、候補の並びも変わります。
1回で全文を書くのではなく、少しずつ続ける
LLMは、完成した文章を一度に出力しているわけではありません。1回目に「晴れ」を選ぶと、入力文は「明日の天気は晴れ」になります。この入力文から2回目の候補を出し、「でしょう」を選ぶと、入力文は「明日の天気は晴れでしょう」に伸びます。3回目に「。」を選び、最後に文章を終わらせる選択をすると、生成が止まります。
チャット画面で返答が少しずつ表示されるサービスがあるのは、この性質と関係しています。
ここまで「言葉」と書いてきましたが、実際にLLMが扱う単位は、単語や文字ではなく「トークン」という区切りです。トークンは、単語の一部や記号になることもあります。図3と図4では分かりやすさのために単語で描いています。トークンの詳しい話は、別の記事で扱います。
スマートフォンで文字を打つと、次の候補が並び、1つ選ぶと続きが入力されます。LLMの流れはこれに似ているため、入口のイメージとしては役に立ちます。ただし、これは仕組みそのものではありません。LLMは長い文章の文脈全体を手掛かりにして、多くの予測入力よりはるかに複雑な計算で候補を決めます。
学習と、質問に答えるときは別の段階
LLMの「次の言葉を選ぶ力」は、質問を受けた時点で身に付けるものではありません。利用の前に、大量の文章を使った学習で身に付けています。
学習では、文章の途中までを見せて「次に来る言葉」を当てさせ、外れていればモデル内部の数値(パラメータ)を調整する、という作業を大量の文章で繰り返します。文章そのものが正解になるので、人が1つずつ正解を付ける必要はありません。実際のサービスでは、この後にさらに調整が加わることがあります。調整の話は、別の記事で扱います。
利用時は、完成したLLMに入力を渡して、続きを生成させます。このときパラメータは変わりません。
| 項目 | 学習 | 利用時 |
|---|---|---|
| 行うタイミング | サービスとして使えるようになる前 | 質問や指示を受けるたび |
| 入力するもの | 大量の文章 | 利用者の質問や指示、資料など |
| パラメータ | 調整される | 変わらない |
| 目的 | 次に来る言葉を当てられるようにする | 入力に続く文章を生成する |
多くのチャットサービスで、AIが前の発言を踏まえて答えられるのは、前の発言が入力に含まれているからです。モデル内部に書き込まれているわけではありません。サービスによっては利用データを今後の学習に使うことがありますが、それは別に行われる学習であり、返答を作っている最中に起きるものではありません。
「自然な文章」と「正しい情報」は別
LLMが選んでいるのは、文脈の続きとして自然な言葉です。「明日の天気は晴れでしょう」と続けたとき、LLMが明日の実際の天気を調べたとは限りません。天気予報などの外部の情報につながっていない場合、この文は、天気の話題でよく使われる言葉の並びから作られたものです。
学習に使った文章には時期の区切りがあるため、それより新しい出来事は含まれていません。学習した文章に誤りがあれば、その傾向も引き継ぎます。文章が滑らかでも、内容が正しいことの保証にはなりません。
もっともらしいのに事実と異なる出力は、ハルシネーションと呼ばれます。起こる場面と確認の仕方は、別の記事で扱います。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| 生成AI | 文章、画像、音声などを新しく作るAI |
| LLM | Large Language Model(大規模言語モデル)。大量の文章から、言葉の並び方のパターンを学んだモデル |
| トークン | LLMが文章を扱うときの小さな区切り。単語や文字と一致しない場合がある |
| 学習 | 大量の文章を使い、次に来る言葉を当てられるようにパラメータを調整する段階 |
| パラメータ | モデル内部の数値。学習で調整され、利用時には変わらない |
| ハルシネーション | もっともらしいが事実と異なる出力 |
コメント