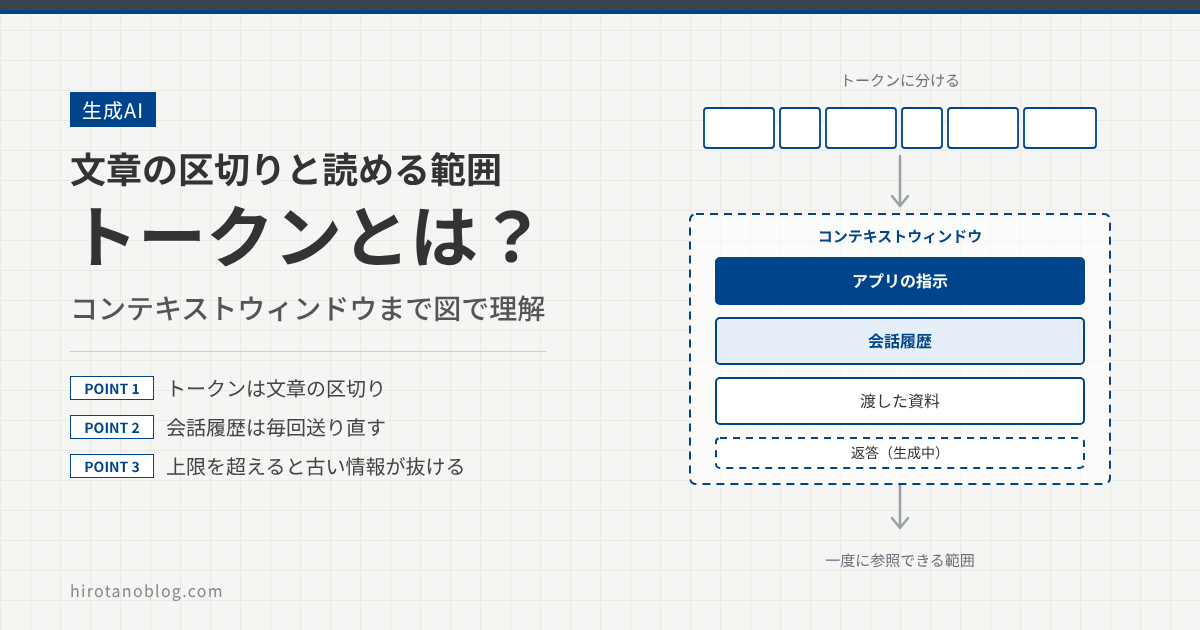
AIに長い資料を渡したのに、後半の内容が回答に反映されない。長い会話の途中で、前に伝えた条件を踏まえなくなる。こうした場面には、AIが文章を扱う単位と、一度に参照できる量の上限が関係しています。
この記事では、文章を扱う単位である「トークン」と、参照できる範囲である「コンテキストウィンドウ」を、図を使って整理します。LLMが次のトークンを1つずつ選んで文章を作ることは、前提として使います。
- トークンは、LLMが文章を扱う小さな区切りで、文字数や単語数とは一致しないこと
- AIは前の会話を覚えているわけではなく、過去のやり取りも含めて毎回送り直していること
- 送れる量にはコンテキストウィンドウという上限があり、長いチャットでは古い情報が使われなくなる場合があること
- 枠に入れた情報が、すべて正しく使われるとは限らないこと
トークンはAIが扱う文章の「区切り」
LLMは、文章を文字や単語のまま扱っているわけではありません。文章を「トークン」という小さな区切りに分け、そのトークンを単位にして次の1つを選びます。トークンは、1つの単語、単語の一部、記号などになり得ます。
英語の「annoyingly」は、「annoy」「ing」「ly」のように、単語の一部に分けられることがあります。よく使われる単語は1つのトークンのまま、まれな単語は部分に分けられるのが、おおよその傾向です。日本語の区切り方も、単語や文字とそろうとは限りません。
同じ長さの文でもトークン数は変わる
同じ程度の長さの文でも、日本語、英語、数字、記号では区切られ方が違います。そのため、文字数や単語数からトークン数を正確に求めることはできません。OpenAIのヘルプでは、英語の目安として1トークンがおよそ4文字、100トークンがおよそ75語とされています。ただし、これは概算です。言語が変われば、文字、単語、トークンの関係も変わると説明されています。
区切り方は、モデルによっても異なります。Anthropicの公式ドキュメントでは、新しいトークナイザを使うモデルで、同じ入力でも以前のモデルより約30%多いトークン数になると説明されています。トークン数は、実際に使うモデルで数え直す必要があります。
コンテキストウィンドウは「今、参照できる範囲」
コンテキストウィンドウは、LLMが返答を作るときに参照できるテキスト全体を指します。学習に使った大量の文章とは別のもので、そのやり取りのための「作業用の記憶」にあたります。
この枠には、アプリ側の指示、会話履歴、渡した資料、そしてLLMが生成中の返答が入ります。返答も枠を使うため、長い資料を入れるほど、返答に使える余地は減ります。枠の大きさは、モデルや利用条件によって異なります。
机の上に同時に広げられる資料の面積にたとえられます。ただし、机に載せた資料がすべて読まれるわけではありません。たとえは仕組みそのものではなく、イメージです。
ここで、よくある誤解を整理します。LLMは、前のやり取りを覚えているわけではありません。1回ごとのリクエストは独立しているため、前の会話を踏まえた返答をさせるには、過去の質問と返答もすべて含めて、毎回入力として送り直す必要があります。多くのチャットアプリでは、この送り直しをアプリ側が行っています。そのため、利用者にはAIが会話を覚えているように見えます。
長い会話では、古い情報が使えなくなる場合も
会話を続けるほど、毎回送り直す履歴は長くなり、入力はコンテキストウィンドウの上限に近づきます。上限を超えたときの扱いは、サービスによって異なります。Claudeの公式ドキュメントでは、チャット画面で古い部分から順に管理する方式、古い部分を要約して続ける方式、入力だけで上限を超えるとAPIがエラーを返す動作が説明されています。
1つのチャットで長く使い続けると、ずっと前に伝えた内容が枠から外れ、返答を作るときに参照されなくなることがあります。最初に伝えた条件が外れると、その条件を踏まえない返答になります。また、上限に達する前でも、入力が長くなるほど正確さが下がる傾向が報告されています(次の見出しで説明します)。
長いチャットで答えがかみ合わなくなったときは、重要な条件を書き直して送るか、要点をまとめて新しいチャットで始め直すと、改善する場合があります。
長文を渡すときの実践ポイント
長い文章を渡すときは、次の3点を意識すると、枠の中身を整理しやすくなります。
| 工夫 | 内容 | 期待できること |
|---|---|---|
| 必要な資料に絞る | 関係のない資料を外し、質問に必要な部分だけを渡す | 枠を使い切らず、返答の余地も残せる |
| 質問と条件を明確にする | 目的、守る条件、出力の形式を、資料とは分けて書く | 何をしてほしいかが資料に埋もれにくい |
| 長い資料は分けて扱う | 章や節ごとに質問し、必要なら結果をまとめ直す | 1回の入力を短くできる |
「入れた情報」と「正しく使った情報」は別
枠に収まっていても、LLMが必要な箇所を使えるとは限りません。2023年の研究「Lost in the Middle」では、必要な情報が入力の先頭か末尾にあるときに性能が高く、中ほどにあるときは大きく下がる傾向が報告されました。
この現象が最新のモデルでも同じように起きるかは、モデルや課題によって結果が分かれます。2025年11月の研究では、Gemini 2.5 Flashが、1つの事実を探すだけの単純な質問では、位置によらず正しく答えられたと報告されています。一方、2026年1月公開の別の研究では、Claude 4.5 Haikuなど一部のモデルで、必要な情報が中ほどにあるときに論理的な推論の正確さが下がるU字型の低下が見られたと報告されています。
位置に限らず、入力が長くなるほど正確さが下がる傾向は、複数の研究で報告されています。Chromaが、Claude、GPT、Gemini、Qwenなど18のモデルを調べた2025年7月のレポートでは、単純な課題でも入力が長くなるにつれて性能が下がるとされています。2025年のNoLiMaという研究でも、長い入力に対応する13のモデルで、短い入力に比べて性能が大きく下がることが示されました。Anthropicは、この現象を「コンテキストロット」と呼び、コンテキストを限りある資源として扱うよう説明しています。
まとめると、「中ほどが使われにくい」という位置の影響はモデルによって小さくなっている場合がありますが、入力が長くなるほど精度が落ちる傾向そのものは、今も報告されています。ただし、ここで紹介した研究が対象にしたのは、主に2025年に公開されたモデルです。
枠が大きいことは、長い資料を渡せるという意味であり、すべてを正しく使うという意味ではありません。資料は絞ったうえで、重要な情報は目立つ位置にも書き、返答が根拠にしている箇所は元の資料で確認してください。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| トークン | LLMが文章を扱う小さな区切り。モデルや言語によって、区切り方とトークン数が変わる |
| コンテキストウィンドウ | LLMが返答を作るときに参照できる範囲。指示、会話履歴、資料、返答が同じ枠を使う |
| 入力トークンと出力トークン | 渡した内容のトークンと、生成された返答のトークン。どちらも枠を使う |
| コンテキストロット | トークン数が増えるにつれて、正確さと再現率が下がる現象(Claudeのドキュメントでの呼び方) |
トークン
- Hugging Face:Tokenizer summary(サブワードによる区切り、モデルごとのトークナイザ)
- OpenAI Help:What are tokens and how to count them(トークン数の目安)
- Claude Docs:Token counting(トークナイザの違いとトークン数)
コンテキストウィンドウと会話履歴
- Claude Docs:Context windows(枠の定義、会話履歴の蓄積、上限での扱い、コンテキストロット)
- OpenAI API Docs:Conversation state(リクエストが独立していること、履歴を入力として渡すこと)
長い入力での精度
- Liu et al.:Lost in the Middle(2023年)
- Retrieval Quality at Context Limit(2025年11月、Gemini 2.5 Flashでの検証)
- Not All Needles Are Found(2026年1月、Gemini 2.5 Flash・GPT-5 mini・Claude 4.5 Haiku・DeepSeek-V3.2の比較)
- Chroma:Context Rot(2025年7月、18モデルの検証)
- NoLiMa:Long-Context Evaluation Beyond Literal Matching(2025年)
- Anthropic:Effective context engineering for AI agents(コンテキストロットの説明)
コメント