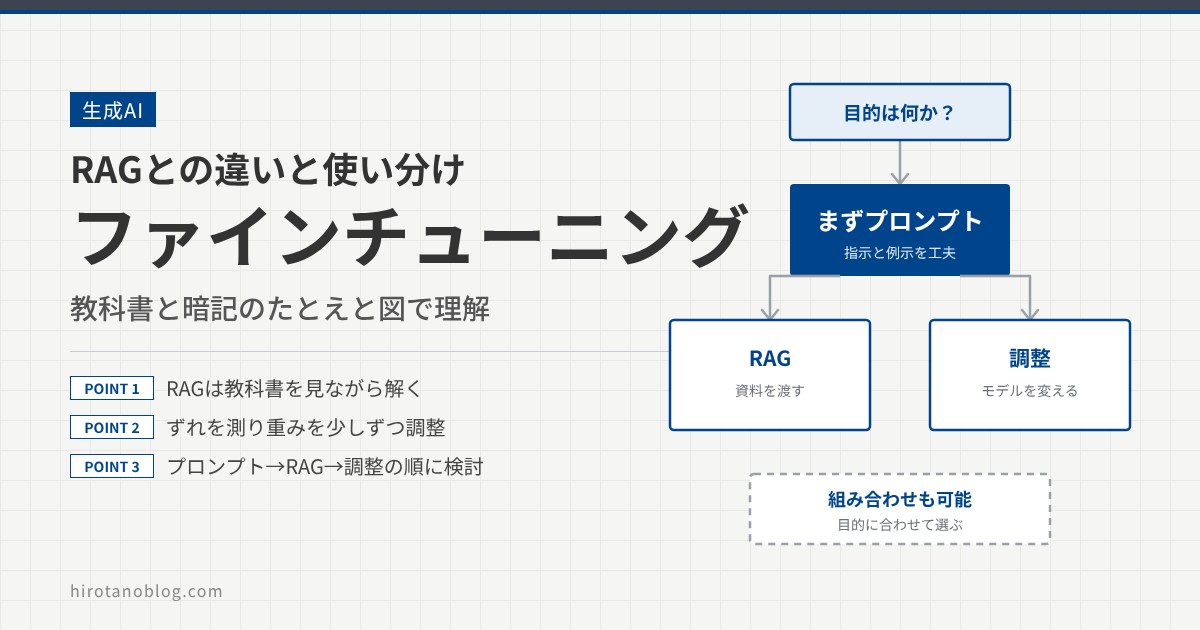
AIに自社向けの答え方をさせたいとき、「ファインチューニング」という言葉が出てきます。追加のデータでモデルを調整する方法です。一方で、資料を探して渡す「RAG」という方法もあります。この記事では、2つの違いを、試験のたとえで説明します。続いて、学習ではモデルの中で何をしているのか、なぜ時間や電力がかかるのかを、数式を使わずに図で説明します。最後に、プロンプトも含めた選び方と、調整する前の確認事項を整理します。
- RAGは教科書を見ながら解く方法、ファインチューニングは勉強して頭に入れる方法
- 学習では、例とのずれを測り、モデルの中のつまみ(重み)を少しずつ動かすことを大量に繰り返す
- 指示と例で足りるか、知識の更新が必要か、繰り返す振る舞いを直したいか、の順に考える
- 調整にはデータ・評価・費用・プライバシーの確認が必要で、誤回答はなくならない
ファインチューニングは何を変える?
ファインチューニング(fine-tuning)は、すでに学習済みのモデルに、追加のデータで学習させて、特定の用途に合わせる方法です。Microsoftのドキュメントは、プロンプトに例を足すのではなく、モデルの重みを調整する、と説明しています。ゼロからモデルを作るわけではなく、元のモデルの能力の上に積み上げます。
使い道として、同じドキュメントは、回答の口調・形式・スキーマを揃えること、プロンプトの例を減らしてトークン費用や待ち時間を下げること、小さなモデルを特定の仕事に特化させることなどを挙げています。OpenAIのドキュメントも、決まった形式での出力や、分類のような用途を向いているものとして挙げています。
ただし、効果は保証されていません。Microsoftのドキュメントは、効果は保証されないので、取り置いた評価用データで、元のモデルと比べて確かめるよう述べています。
「学習し直す」と「その場で資料を読む」の違い
試験にたとえると、RAGは、教科書を横に置いて、見ながら解く方法です。ファインチューニングは、事前に勉強して頭に入れ、何も見ずに解く方法です。
| 観点 | ファインチューニング | RAG |
|---|---|---|
| 変わるもの | モデル(重み) | 回答時に渡す資料 |
| 主な狙い | 形式・口調・繰り返す判定などの振る舞い | 社内資料や新しい情報を根拠にした回答 |
| 内容を変えるとき | データを用意して、学習し直す | 保存した資料を更新する |
| 出典の表示 | 調整だけでは、元の資料は示せない | 参照した箇所を示せる |
このたとえには、続きがあります。勉強して頭に入れたつもりでも、細かい事実を正確に思い出せるとは限りません。一方、教科書を見ながら解くなら、書いてある箇所を探して読めます。
実際に、知識を覚えさせる目的では、Ovadiaらの研究が、教師なしのファインチューニングよりも、RAGのほうが一貫して良い結果だったと報告しています。AWSがClaude 3 Haikuの調整について書いた記事でも、新しい知識を覚えさせて一般的な作業に使わせる目的は、成功の見込みが低いと整理されています。また、Microsoftのドキュメントも、ファインチューニングは、最新の情報を扱うための検索の代わりにはならない、と述べています。
なお、2つは対立するものではありません。Microsoftのドキュメントは、調整によって、検索で見つけた内容を、より上手に使えるよう学習させる使い方も挙げています。
学習では何をしている?
「モデルを調整する」と聞いても、中で何が起きているのか、想像しにくいと思います。ここでは、数式を使わずに、イメージをつかみます。ここで説明するのは、機械学習で広く使われる基本の考え方です。OpenAIやClaudeなどのサービスが、内部でどの方法を使っているかは、公開されていません。
1サイクルは、4つの動きです。まず、入力と正解の組(学習用の例)を1つ見ます。次に、今のモデルで答えを予測します。そして、正解との差(ずれ)を測ります。最後に、ずれが小さくなる向きに、モデルの中の数値(重み)を、ほんの少しだけ動かします。
Googleの機械学習講座も、この考え方を、重みを、損失(ずれ)が小さくなる向きに、少しだけ動かすことを繰り返す方法として説明しています。
| 設定の名前 | イメージ |
|---|---|
| エポック | 学習用データを、何周するか |
| バッチサイズ | 何件の例を、まとめて見てから重みを動かすか |
| 学習率(の倍率) | 1回に、重みを動かす幅 |
OpenAIのAPIでも、AWSのClaude 3 Haikuの記事でも、これらは調整できる設定として登場します。設定の選び方で結果が変わるため、評価を見ながら調整します。
モデルの中身は、大量のつまみ
モデルの中の数値(パラメータ、重み)は、大量のつまみにたとえられます。調整前に、どのつまみがどの位置にあるかで、モデルの振る舞いが決まっています。
学習では、このつまみを、1つずつではなく、全体として少しずつ動かします。たとえば、LoRAの論文は、GPT-3の175Bというモデルを例にしています。これは、1750億個の重みを持つ規模です。1個ずつのつまみに、人が読み取れる意味はなく、全体として振る舞いを決めます。
このため、調整した結果、狙ったこと以外にも影響が出る可能性があります。調整後に、元の用途の性能も評価して確かめるのは、そのためです。
なぜ時間や電力がかかるのか
学習の計算量は、おおまかに、データの量、繰り返す回数、モデルの大きさで増えます。1回の更新で、大量のつまみを計算し直し、それを、大量の例で何周も行うためです。専用の計算機(GPU)を使って行います。
ニュースで聞く膨大な電力は、多くの場合、最初の大規模な事前学習の話です。事前学習のあとに行う調整にも、電力はかかります。ただし、BERTの調整のエネルギーを調べた論文によると、1回あたりでは、事前学習のほうがはるかに多くの電力を使います。一方で、調整は、より多くの人が、より頻繁に行うため、全体では無視できない量になる、と述べられています。
調整の計算量を抑える工夫もあります。その1つがLoRAです。論文では、GPT-3の175Bを、全部のつまみを更新する場合と比べて、学習する対象を約1万分の1、GPUメモリを約3分の1に減らせると報告されています。
LoRA(Low-Rank Adaptation)は、元のモデルの重みを固定したまま、小さな追加の部品だけを学習する方法です。つまみを全部動かす代わりに、少数の追加部品だけを動かすイメージです。この記事の主題ではないので、ここでは「調整の計算量を減らす工夫の1つ」と捉えてください。
OpenAIやClaudeのAPIでは何が起きているのか
利用者から見える流れは、どのサービスでも似ています。例データを用意して、学習ジョブを作ります。サービス側のGPUで学習が行われ、終わると、調整済みのモデルが、専用のモデルIDで使えるようになります。
| サービス | 公式ドキュメントで確認できる内容 |
|---|---|
| OpenAI | JSONLファイルをアップロードし、ベースモデルと一緒にジョブを作る。完了すると、調整済みのモデルIDが得られる。データは、モデルの重みを更新するために使われる。エポックごとに、モデルの保存点(チェックポイント)が作られる |
| Claude 3 Haiku(Amazon Bedrock) | 入力と理想の出力の組を用意して、調整済みのClaude 3 Haikuを作る。2024年7月にプレビュー、同年11月に一般提供と案内された。学習用データは、利用者のAWS環境の中にとどまると説明されている |
| Microsoft Foundry | データと設定を送ると、Foundryが学習ジョブを実行する「マネージド」の方式がある |
重みの更新を、全部のつまみで行うのか、LoRAのように一部だけで行うのかは、各社の公式ドキュメントでは確認できませんでした。OpenAIのドキュメントは、データを使って重みを更新する、とだけ述べています。
まず何を選ぶ?プロンプト・RAG・調整
調整は、準備にも運用にも手間がかかります。そのため、順に考えるのが基本です。OpenAIのドキュメントは、プロンプトの工夫だけで十分な結果が得られる場合がある、と述べています。ClaudeのドキュメントやOpenAIのドキュメントはどちらも、先に、成功の基準と評価の方法を決めておくことを勧めています。
| 順番 | 確認すること | 選択肢 |
|---|---|---|
| 1 | 指示や例を書けば、求める答えになるか | まずプロンプトを工夫する |
| 2 | 更新される情報や、社内の資料が必要か | RAGで、回答時に資料を渡す |
| 3 | 形式や判定など、同じ振る舞いを繰り返し直したいか | ファインチューニングを検討する |
Claudeのドキュメントには、速度や費用の問題は、モデルを変えるほうが簡単に解決できる場合がある、という趣旨の記述もあります。調整の前に、別のモデルを試すのも選択肢です。
よくある選び分けの例
3つの場面で、考え方を比べます。あくまで例で、実際には評価して決めます。
| 場面 | 考え方 |
|---|---|
| 回答形式を揃える | まず、形式の指示と例をプロンプトに入れて試す。それでも揃わず、例が十分にあるなら、調整を検討する |
| 毎週変わる社内規程に答える | 知識が変わり続けるので、RAGが向く。調整だと、変わるたびに学習し直すことになる |
| 専門文書の定型分類 | 同じ判定を大量に繰り返し、正解の例を用意できるなら、調整が向く場合がある。まず、プロンプトで十分か確かめる |
調整する前に確認したいこと
ファインチューニングは、やれば必ず良くなる、というものではありません。Microsoftのドキュメントは、これを、試行を重ねる工学的な作業であって、改善が保証されたものではない、と説明しています。始める前に、次の5つを確認します。
| 確認すること | 中身 |
|---|---|
| データの質 | 正確で、一貫していて、実際の使い方に合った例か。抜けている場面、重複、偏り、機密情報がないかを、アップロード前に点検する |
| 評価方法 | 調整の前に基準を決め、学習用・検証用・最終試験用のデータを分ける。学習データで試すと、覚えただけの結果になる(過学習) |
| 費用 | 学習のやり直し、評価、運用(ホスティング)、推論の費用を見込む。効果が出なければ、試行を止める |
| プライバシー | 学習に使うデータを、事前に点検する。機密情報や個人情報が混ざっていないかを確認する |
| 元の性能への影響 | 調整後のモデルを、元のモデルと同じ評価データで比べ、他の用途に悪影響がないかを確かめる |
調整できるかどうかは、ベンダーやモデルによって異なります。たとえばOpenAIのドキュメントには、2026年10月時点で、ファインチューニングのプラットフォームは新規ユーザーが使えなくなっている、という記載があります。使いたいモデルで調整が提供されているか、先に公式ドキュメントで確認してください。
また、モデルが新しい版に変わったり、提供が終わったりしたときには、品質を見直し、学習し直しが必要になる場合があります。Microsoftのドキュメントも、保守の項目として挙げています。
調整しても誤回答はなくならない
調整しても、RAGを使っても、AIの誤回答はなくなりません。足りない部分を補う方法が、それぞれ違うだけです。
| 課題 | 考え方 |
|---|---|
| 事実の更新 | 調整で覚えさせるより、資料を更新できるRAGで扱う。調整は最新情報の検索の代わりにならない |
| 根拠の提示 | 回答に出典を付け、人が元の資料で確かめられるようにする |
| アクセス制御 | 見てよい資料だけを検索の対象にする。学習に使った内容はモデルの中に入るため、利用者ごとの出し分けは、検索の段階で絞れるRAGのほうが扱いやすいと考えられる |
Microsoftのドキュメントも、ファインチューニングは、アプリケーション側の安全対策の代わりにはならない、と述べています。誤回答がどんな場面で起きるのか、どう確認すればよいのかは、別の記事で扱います。
この記事は、OpenAIやAnthropic、Microsoft、AWSなどの公式ドキュメントと、公開されている論文をもとに書いています。読み違いや誤りが含まれている可能性があります。また、サービスの提供状況や仕様は変わりやすく、記事の情報が古くなっている場合もあります。実際に利用するときは、必ず最新の公式ドキュメントで確認してください。
ファインチューニングの定義と使い道
- Microsoft Learn:Fine-tuning overview(定義、使いどころ、課題と制限)
- OpenAI:Model optimization(評価、プロンプト、調整の進め方)
- OpenAI:Supervised fine-tuning(用途、データ、評価、ジョブの流れ)
- Anthropic:Fine-tune Claude 3 Haiku in Amazon Bedrock(2024年)
- AWS:Best practices and lessons for fine-tuning Claude 3 Haiku on Amazon Bedrock
学習の仕組みと計算量
- Google:Machine Learning Crash Course(勾配降下法)
- arXiv:LoRA: Low-Rank Adaptation of Large Language Models
- arXiv:Energy and Carbon Considerations of Fine-Tuning BERT
プロンプトと評価
知識の追加は調整かRAGか
コメント