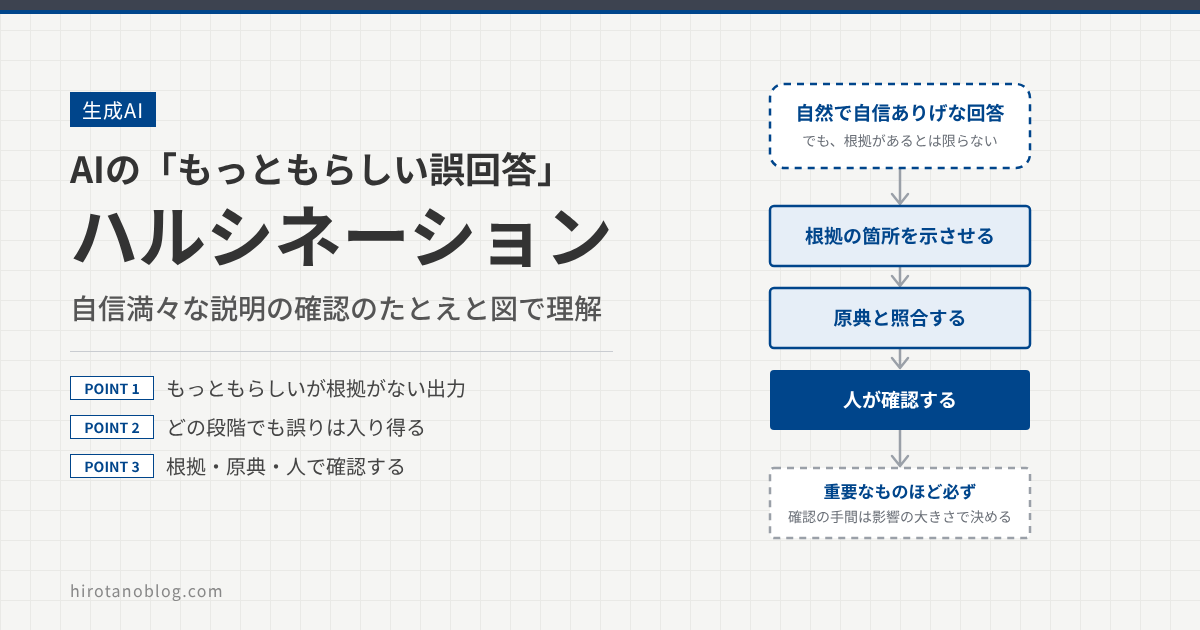
生成AIの回答は、自然で、自信がありそうに読めます。そのため、間違っていても、そのまま信じてしまいがちです。このような「もっともらしい誤り」は、ハルシネーションと呼ばれます。この記事では、どんな誤りなのか、どの段階で入り得るのか、どう確認すればよいのかを、図で説明します。
- ハルシネーションは、もっともらしいが、根拠のない出力。文章の滑らかさでは見抜けない
- 誤りは、質問・検索・資料・生成・回答の、どの段階でも入り得る
- RAGや調整は助けになるが、単独では防げない。根拠・原典・人の確認を組み合わせる
ハルシネーションはどんな誤り?
OpenAIは、ハルシネーションを、言語モデルが生成する、もっともらしいが誤った文、と説明しています。OWASPのLLM向けセキュリティ一覧も、LLMが、信頼できそうに見える誤った情報や、誤解を招く情報を出力することを、誤情報(Misinformation)のリスクとして挙げています。
| 種類 | どんな出力か |
|---|---|
| 存在しない出典 | 実在しない論文、判例、記事などを、根拠として挙げる |
| 誤った数値・日付 | 金額、期限、バージョンなどを、それらしく答える |
| 資料にない断定 | 渡した資料に書いていないことを、書いてあるかのように言い切る |
| 古い・ずれた情報 | 前提の違う情報や、更新前の情報を、現在の話として答える |
OWASPは、実際の例として、ChatGPTが架空の判例を作り、法廷で問題になったことを挙げています。
なぜ「流暢さ」で見抜けない?
自信満々に話す人の説明でも、契約の条件や日付は、原本で確かめます。AIも同じです。LLMは、前の言葉に続く、自然な言葉を選んで文章を作ります。仕組みは、別の記事で扱いました。そのため、根拠があるかどうかに関係なく、文章は滑らかになります。
OpenAIは、誤りが残る理由の1つとして、評価のしかたを挙げています。正解率だけで評価すると、分からないと答えるよりも、推測して答えるほうが有利になります。標準的な学習や評価が、不確かさを認めることより、推測を報いてしまう、という説明です。
一方で、OpenAIは、不確かなときは、答えないことも可能だと述べています。「分からない」と言えるようにすることが、対策の方向になります。
どの段階で誤りが入り得る?
誤りは、LLMが文章を作る段階だけで起きるわけではありません。資料を探して答える仕組み(RAG)を含めて、流れに沿って整理します。
| 段階 | 起こり得ること | 確認すること |
|---|---|---|
| 1 質問 | 質問があいまいで、前提が足りず、別の意味で答える | 条件や範囲を、質問に書く |
| 2 検索・資料 | 検索で外れた資料が選ばれる。古い資料が出る | 参照元の資料と、更新日を確かめる |
| 3 生成 | 資料を読み違える。資料にないことを、推測で言い切る | 回答の根拠の箇所を確かめる |
| 4 回答 | 確認されずに、そのまま使われる | 用途に応じて、人が確認する |
RAGで、検索が外れる、資料から読み取れない、といった失敗が起きる点は、別の記事で扱いました。
RAGやファインチューニングの限界
RAGは、根拠になる資料を渡すことで、誤回答を減らす助けになります。OWASPも、信頼できる外部の情報源から取り出した内容で回答を支える方法として、RAGを挙げています。ファインチューニングは、形式や振る舞いを揃える助けになる場合があります。
ただし、どちらも、単独で誤回答をなくす方法ではありません。RAGでは、検索の外れや古い資料、読み違いが起きます。ファインチューニングは、最新の情報を扱う検索の代わりにはなりません。それぞれの詳細は、別の記事で扱いました。
誤回答を減らす実践的な確認
Claudeのドキュメントは、ハルシネーションを減らす方法を、いくつか挙げています。そのうえで、これらの方法は、ハルシネーションを大きく減らすが、完全にはなくせない、と述べています。重要な情報は、必ず確かめる前提で使います。
| 確認 | やり方 |
|---|---|
| 分からないと言ってよい | 「分からない場合は、分からないと答えてください」と、明示的に許可する。Claudeのドキュメントは、これだけで誤情報を大きく減らせる場合がある、としている |
| 根拠の箇所を示させる | 長い文書では、先に、該当箇所をそのまま引用させてから答えさせる。主張ごとに、引用や出典を付けさせる方法もある。裏付けとなる引用が見つからない主張は、取り下げさせる |
| 原典と照合する | 数値、日付、固有名詞、出典は、元の資料やサイトで確かめる。AIが示した出典が、実在するかも確かめる |
| 用途に応じて人が確認する | OWASPも、重要な情報には、人による確認と事実確認の仕組みが必要としている |
確認の手間は、間違えたときの影響で決めます。アイデア出しなら軽くて構いません。数値、契約、手順、出典を含むものは、原典まで確かめます。
AIセキュリティの学習へつなぐ
ここまでの誤回答は、悪意がなくても起きる、モデルの誤りです。一方、悪意ある入力や、権限の問題によるリスクは、別に扱います。OWASPの一覧でも、誤情報(LLM09)と、プロンプトインジェクション(LLM01)、機密情報の漏えい(LLM02)、過剰な権限(LLM06)は、別の項目です。
| 観点 | 誤回答 | AIセキュリティ |
|---|---|---|
| きっかけ | 悪意がなくても起きる | 悪意ある入力や、権限の設定の問題 |
| 例 | 存在しない出典、資料にない断定 | プロンプトインジェクション、情報漏えい、権限の逸脱 |
| 主な対策 | 根拠の確認、原典との照合、人の確認 | 入力・権限・出力の制御と監視 |
誤回答への確認と、セキュリティへの対策は、どちらも必要です。後者は、別の記事で扱います。
この記事は、OpenAIやAnthropic、OWASPなどの公開資料をもとに書いています。読み違いや誤りが含まれる可能性があります。また、サービスの仕様や研究の状況は変わりやすく、記事の情報が古くなっている場合もあります。実際に利用するときは、必ず最新の公式資料で確認してください。
ハルシネーションの定義と原因
誤回答を減らす方法
セキュリティとの区別
コメント