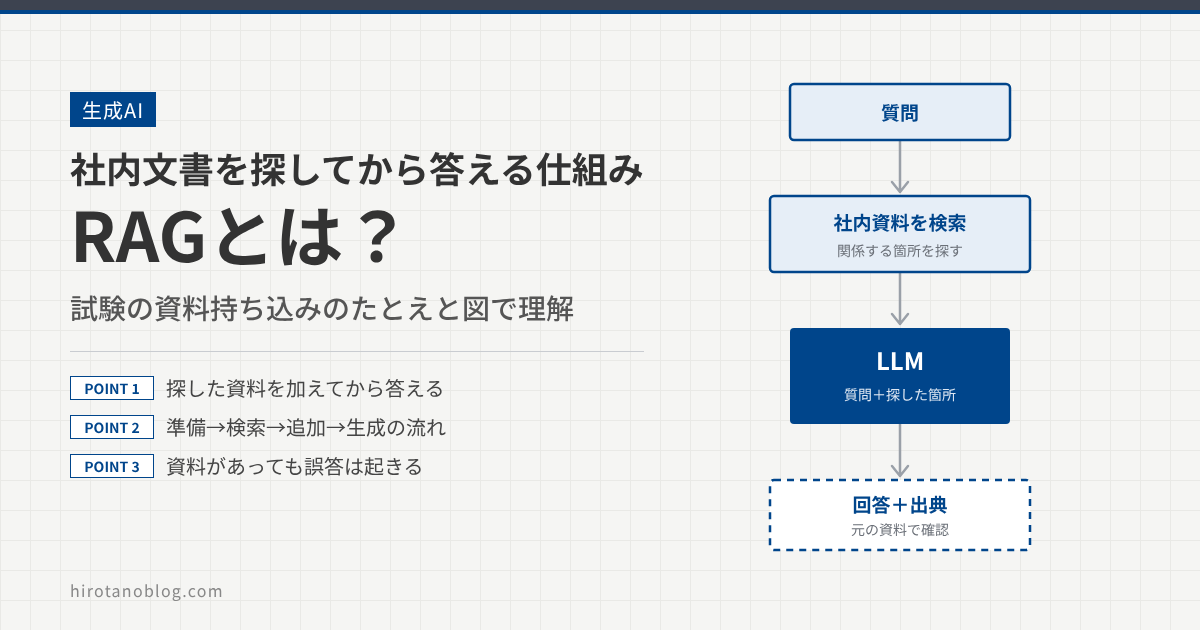
ChatGPTやClaudeのようなAIは、社内の規程や、学習のあとに出た新しい製品情報を、そのままでは知りません。そこで使われるのが「RAG(ラグ)」です。関連する資料を探し、それをAIに渡してから答えさせる仕組みです。この記事では、RAGの流れと、RAGでも誤回答が起きる理由、出典表示と閲覧権限の考え方を、図で説明します。
- RAGは、質問に関係する資料を探し、プロンプトに加えてから回答を生成する仕組み
- 流れは「文書の準備、検索、プロンプトへの追加、回答の生成」の4ステップ
- 資料を渡しても誤回答は起きる。出典表示と、閲覧権限の確認が欠かせない
モデルが知らない社内情報に答えるには?
LLMは、学習で得た知識をもとに答えます。学習データに含まれていない社内規程や、学習のあとに出た新しい情報は、答えの材料になりません。試験にたとえると、記憶だけで答えている状態です。
そこで、質問を受けたときに、外部の資料から関係する箇所を探してAIに渡す、という発想が出てきます。試験で、許可された資料を開いてから答えるようなものです。ただし、資料を開いても、読み間違いは起こります。
AWSの解説は、RAGを、LLMが答える前に、学習データの外にある知識ベースを参照させる仕組みと説明しています。モデルを再学習させるよりも、新しい情報を加える方法としてコストを抑えられる、とされています。
RAGは「探してから答える」構成
RAGは、Retrieval-Augmented Generation(検索で拡張した生成)の略です。検索で見つけた情報を、LLMへの入力に加えて、回答を生成します。
| 言葉 | 意味 |
|---|---|
| Retrieval(検索) | 質問に関係する資料や箇所を、外部から探す |
| Augmented(拡張) | 探した内容を、LLMへの入力(プロンプト)に加える |
| Generation(生成) | LLMが、加えられた内容も踏まえて回答を作る |
この名前は、Lewisらが2020年に発表した論文で使われたものです。論文では、事前に学習したモデルの中の知識(パラメータ記憶)と、Wikipediaのベクトル索引のような外部の知識(非パラメータ記憶)を組み合わせています。
RAGの4ステップを追う
RAGの流れは、あらかじめ行う準備と、質問のたびに行う処理に分けられます。
| ステップ | 何をするか |
|---|---|
| 1 文書を準備する | 社内の文書などを、検索しやすい大きさに区切って保存する |
| 2 関係する箇所を探す | 質問に合う箇所を、保存した文書の中から探す |
| 3 参考箇所を加える | 見つけた箇所を、指示や質問と一緒にプロンプトへ入れる |
| 4 回答を生成する | LLMが、プロンプトの内容をもとに回答を作る。参照元を示す場合もある |
AWSの解説では、この4つに加えて、外部データを更新し続けることも挙げられています。文書が変わっても、保存したデータが古いままだと、古い内容で答えてしまうためです。
EmbeddingとベクトルDBはどこで働く?
ステップ1と2が、EmbeddingとベクトルDBの出番です。文書をベクトルにして保存しておき、質問も同じモデルでベクトルにして、近い箇所を探します。これらの仕組みは、別の記事で扱いました。
ただし、RAGの検索は、ベクトル検索だけとは限りません。Microsoftのドキュメントは、キーワード検索とベクトル検索を組み合わせたハイブリッド検索を、漏れを減らす方法として挙げています。どの検索を使うかは、扱う文書や用途によって決まります。
RAGでも誤回答が起きる理由
RAGは、AIが根拠にできる資料を増やす方法ですが、誤回答をなくす方法ではありません。検索が外れれば、外れた資料をもとに、もっともらしい答えが作られます。
RAGシステムの失敗点を整理した研究(Barnettらの論文)は、7つの失敗点を挙げています。この記事では、そのうちの代表的なものと、別の研究で報告されている点を合わせて、主な理由を整理します。
| 理由 | 起こること | 対策の方向 |
|---|---|---|
| 必要な箇所が見つからない | 答えが書かれた資料が、上位に来ず、渡されない。使われるのは上位の数件だけのため | 検索方法や、文書の区切り方を見直す |
| 資料にないのに答える | 資料に答えがない質問でも、「分からない」と答えず、答えを作ってしまう | 資料にない場合はそう答えるよう指示し、確認する |
| 資料から読み取れない | 資料に答えがあっても、余計な情報や矛盾する情報があると、取り出せないことがある | 資料を整理し、重複や矛盾を減らす |
| 古い資料が出る | 更新されていない資料から答えてしまう | 外部データを更新し続ける |
| 入力の中ほどが使われにくい | 関連情報が長い入力の中ほどにあると、先頭や末尾にある場合より、性能が下がることがある | 渡す量を絞る。重要な箇所を目立つ位置に置く |
最後の点は、2023年のLiuらの研究(Lost in the Middle)で報告されたもので、当時のモデルでの結果です。現在のモデルで同じとは限りません。
Barnettらの論文は、RAGシステムの確認は、運用しながらでないと十分にできず、堅牢さは、最初から作り込むのではなく、運用の中で育っていくと述べています。作って終わりにせず、実際の質問で確かめ続けることが大切です。
出典表示とアクセス権の確認
回答に参照元(出典)を付けておくと、人が元の資料を開いて、内容を確かめられます。Claudeのドキュメントでは、引用機能が、各主張を支える箇所を返すことで、回答の検証や、利用者への出典の表示ができると説明されています。
ただし、出典が付いていることは、回答が正しいことを意味しません。引用機能について、Claudeのドキュメントが保証しているのは、引用が、渡した文書への有効な参照になっている点です。その箇所を正しく読み取っているかは、人が確かめる必要があります。
もう1つ大切なのが、アクセス権です。Microsoftのドキュメントは、社内の非公開の内容をLLMに使わせるには、きめ細かなアクセス制御が必要で、利用者は、許可された内容だけを検索できるべきだと述べています。見せてはいけない資料が参考箇所に入ると、回答に含まれて、見えてしまうためです。
検索で見つかることと、見せてよいことは別です。権限による絞り込みは、検索の段階で行います。ベクトルDBでの扱いは、別の記事で扱いました。AIでの情報漏えいへの対策は、別の記事で扱います。
全体像と用語
ここまでの内容を1枚にまとめると、次の図のようになります。
| 用語 | 意味 |
|---|---|
| RAG | Retrieval-Augmented Generation。検索した情報を入力に加えて、回答を生成する仕組み |
| 参考箇所 | 検索で見つかり、プロンプトに加えられる資料の一部。「グラウンディング(根拠付け)のデータ」とも呼ばれる |
| チャンク | 長い文書を区切った断片。検索の単位になる |
| 出典(引用) | 回答のどの部分が、どの資料のどこに基づくかを示すもの |
| アクセス制御 | 利用者ごとに、見てよい資料だけを検索・表示できるようにする仕組み |
コメント