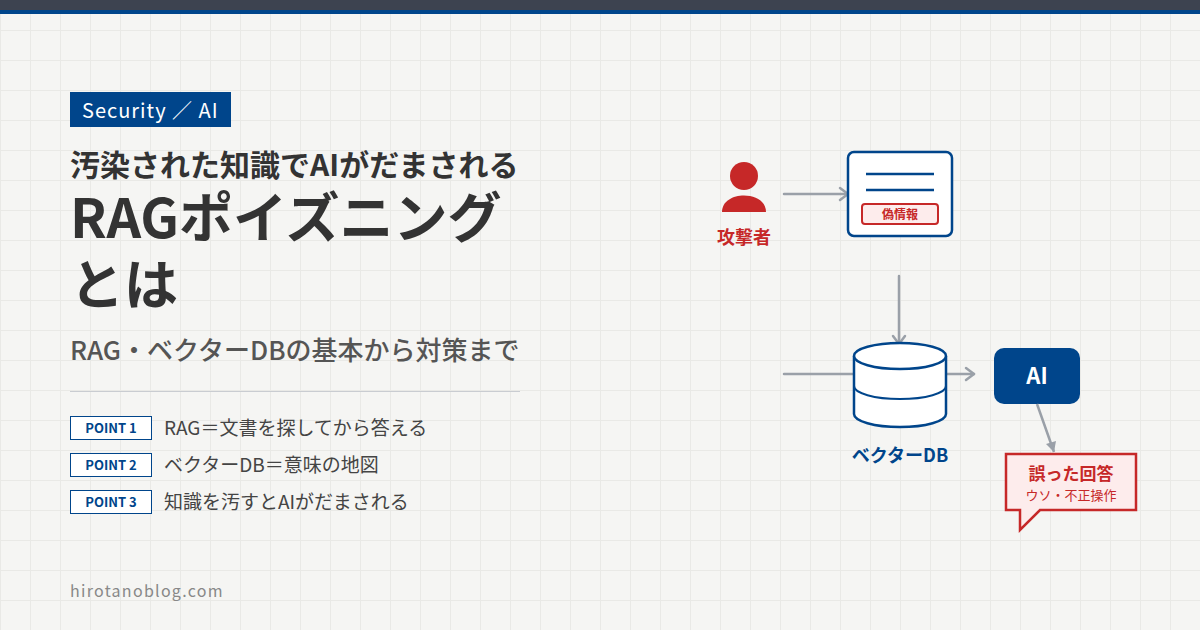
最近のAIチャットは、「社内の規定を調べて答えて」「最新のマニュアルを見て教えて」といった使い方ができるようになってきました。これは、AIがその場で関連する文書を探し、それを読んでから答える「RAG(検索拡張生成)」という仕組みのおかげです。とても便利ですが、AIが参照する知識そのものが汚染されると、AIは平気でウソを答えたり、こっそり仕込まれた命令に従って危ない操作をしてしまいます。これが「RAGポイズニング(RAGポイズニング攻撃)」です。
この記事では、むずかしい数式は使わず、図を交えて、RAGとは何か、その心臓部である「ベクターデータベース」とは何か、そしてRAGポイズニングがどう起きてどう守るのかを、初心者向けにやさしく整理します。
本記事に出てくる攻撃の例や画面は、仕組みを理解するために簡略化した一般的なイメージです。特定の製品やサービスを再現したものではなく、悪用のための手順でもありません。「何が危険で、どう守るか」を知るためのものとしてお読みください。
- RAG(検索拡張生成)=AIが関連文書を探してから答える仕組み
- ベクターデータベース=文章を「意味の地図」に置いて、近い意味を探す仕組み
- RAGポイズニング=その知識を汚染し、ウソを答えさせたり不正操作をさせる攻撃
- どこから汚染されるか、作る側・使う側のそれぞれができる備え
RAGとは何か
RAG(Retrieval-Augmented Generation、検索拡張生成)は、AIが質問に答える前に、関連する文書を外部から探してきて、それを参考にしながら回答を作る仕組みです。AIは学習した知識だけで答えるのではなく、「カンニングペーパー(関連文書)を手元に用意してから答える」とイメージすると分かりやすいです。
これにより、学習時には知らなかった社内文書や最新情報にもとづいて答えられ、思いつきで事実をでっち上げてしまう「ハルシネーション(もっともらしいウソ)」も減らせます。流れは次のとおりです。
ポイントは、回答の中身が「参照した文書」に大きく左右されることです。参照先が正しければ良い回答になりますが、参照先が汚れていれば回答も汚染されます。ここがRAGポイズニングの入り口になります。
ベクターデータベースとは何か
RAGの心臓部が「ベクターデータベース(Vector DB)」です。これは、文章を「意味の近さ」で探せるようにしたデータベースです。ふつうの検索は「同じ単語が含まれるか」で探しますが、ベクターDBは意味が近いかどうかで探せます。たとえば「猫が元気ない」と検索すれば、「猫」という単語がなくても「ペットの体調不良」に関する文書を見つけられます。
カギは「ベクトル(数字の並び)」
その仕組みのカギが「ベクトル」です。高校で習う、いくつかの数をまとめて並べたもの——あのベクトルと同じ考え方です。ベクターDBでは、文章を「意味を表す数字の並び」に変換します。一つ一つの数字が「生きものっぽさ」「ペットっぽさ」「乗りものっぽさ」といった“意味のかけら”を表していて、それをたくさん並べることで、文章全体の意味を数字で表すイメージです。
ポイントは、意味が似ている文章は、数字の並びも似てくることです。たとえば「犬」と「猫」はどちらも生きもの・ペットなので、数字の並びがよく似ます。一方「自動車」は乗りものなので、数字の並びが大きく変わります。つまり似た意味=似たベクトル、遠い意味=遠いベクトルになるわけです。
この「似たベクトルどうしは近い」という性質を使って、文章を“意味の地図”の上に配置できます。意味が近い文章ほど地図の近くに集まってかたまり(クラスタ)を作り、質問も同じ地図に置いて、その「ご近所」にある文章を取り出す——これがベクターDBの検索です。
どれくらい「近い」かは、専門的には数字の並びどうしの近さ(内積など)で測りますが、初心者のうちは「数字の並びが似ているほど近い=意味が近い」というイメージだけで十分です。この地図=知識のあり方が、RAGの回答品質とセキュリティを左右します。
RAGポイズニングとは
RAGポイズニング(RAG Poisoning)は、RAGが参照するベクターDBや外部ナレッジに不正な情報や命令を埋め込み、AIに誤った回答をさせたり、不正な操作を実行させたりする攻撃です。AI本体(LLM)を直接攻撃するのではなく、AIが信頼して読み込む「知識」のほうを汚すのが特徴です。大きく2つのパターンがあります。
パターン①:偽情報を混ぜる(ウソを答えさせる)
知識ベースにもっともらしいウソを紛れ込ませる手口です。AIは参照した文書を信頼するため、その偽情報をもとに自信たっぷりに誤った回答を返してしまいます。しかもRAGの回答は「社内文書にもとづいています」という体裁になりやすく、利用者は信じ込みがちです。
次の画面は実際の製品のものではなく、汚染された回答のイメージを一般化して描いたものです。
社内規定にもとづくと、パスワードの有効期限は設定されていません。変更は不要です。
(実際の規定とは異なる偽情報が参照されている)
パターン②:隠し命令を混ぜる(不正操作をさせる)
文書の中に、利用者からは見えにくい形で「隠し命令」を仕込む手口です。AIがその文書を検索で取り出して読み込むと、文書中の命令を「自分への指示」と勘違いし、情報の持ち出しや不正な操作をしてしまうことがあります。これは、AIが読み込んだデータに紛れた命令に従ってしまう「間接的なプロンプトインジェクション」の一種でもあります。
つまりRAGポイズニングは、知識ベースを経由した間接攻撃です。攻撃者はAIと直接会話しなくても、知識を汚しておくだけで、あとからそれを読んだAIを操れてしまいます。
どこから汚染されるのか
知識ベースは、いろいろな経路から更新されます。そのどれかに「無検査で取り込む隙」があると、汚染の入口になります。
| 汚染されやすい入口 | 例 |
|---|---|
| 公開Webの取り込み | 外部サイトを自動収集してナレッジ化している場合、攻撃者が用意したページが混入する |
| 利用者の投稿・問い合わせ | フォームやチャット履歴を知識に取り込む設計だと、投稿にまぎれた偽情報・命令が入る |
| 共有ドキュメント | 多人数が編集できる文書・Wikiに、こっそり偽情報や隠し命令を書き込まれる |
| 外部データ連携 | 信頼度の低い外部ソースやファイルを、検査せずそのまま取り込む |
作る側・使う側の備え
RAGポイズニングは「AIの知識の信頼性」を狙う攻撃なので、守りも知識の入口から出口までを複数重ねて考えます。特効薬は1つではありません。
知識の入口と権限を固める
- 取り込み元(ソース)の信頼性を管理する。信頼できないソースを無検査で取り込まない
- 取り込み時に検査・サニタイズし、隠し命令や不審なテキストを除去してから知識化する
- 回答に出典(参照した文書)を表示し、重要な内容は裏取りできるようにする
- 利用者ごとに参照できる文書を制限する(権限の最小化)。情報の横断的な持ち出しを防ぐ
- 取り出した文書と回答をガードレールで検査し、危険なツール操作はブロックする
- 知識ベースの変更を監視し、定期的に棚卸し・異常検知を行う
AIの回答を鵜呑みにしない
利用者の側でも、AIの回答に示された出典を確認し、重要な判断にかかわる情報(規定・金額・手順など)は公式の一次情報で裏取りする習慣が効きます。RAGの回答は「それらしく・自信たっぷり」に見えるため、断定的な回答ほど一度立ち止まって確かめると安全です。
まとめ
| 論点 | 要点 |
|---|---|
| RAGとは | AIが関連文書を探してから答える仕組み。回答は参照先に左右される |
| ベクターDBとは | 文章を「意味の地図」に置き、近い意味を取り出す仕組み |
| RAGポイズニング | 知識ベースを汚し、ウソを答えさせる/隠し命令で不正操作をさせる攻撃 |
| こわさ | AIと直接会話せず、知識を汚すだけで後からAIを操れる(間接攻撃) |
| 備え(作る側) | 取り込み元の信頼管理・サニタイズ・出典表示・権限最小化・ガードレール・監視 |
| 備え(使う側) | 出典を確認し、重要情報は一次情報で裏取り。鵜呑みにしない |
RAGは、AIを「自社の知識で賢く答える相棒」に変える強力な仕組みです。その力の源である知識ベースは、裏を返せば攻撃者に狙われる場所でもあります。「AIが何を参照しているか」「その入口は信頼できるか」を見直すことが、RAGポイズニングへの一番の備えになります。
コメント