読む前にこの記事のポイントを音声で確認できます。この音声は本記事をもとにAIツール(NotebookLM)で自動生成したもので、発音や言い回しが不自然な箇所や、内容の誤りが含まれる可能性があります。理解の補助としてご利用ください。
この記事では、Linux の「プロセス」という概念を、基礎からカーネルの内部の動きまで段階的に解説します。コマンドを実際に動かし、/proc やシステムコールの様子を目で見て確かめながら理解を深めていきます。
- プログラム・プロセス・スレッドの違いと、プロセスの状態
- ユーザ空間とカーネル空間、それをつなぐシステムコール
- /proc で見るプロセスの中身(メモリとファイルディスクリプタ)
- fork・exec と Copy-on-Write でプロセスが生まれる仕組み
プログラムとプロセスは何が違うのか
「プログラム」「プロセス」「スレッド」は、なんとなく同じ意味で使われがちです。しかし Linux の世界では、この3つは明確に異なる概念です。ここを区別しておくことが、この先の理解の土台になります。
プログラム:ディスク上の静的なファイル
プログラムとは、ディスク(ストレージ)の上にある静的なファイルのことです。
$ ls -la /usr/bin/bash
-rwxr-xr-x 1 root root 1396520  /usr/bin/bash
/usr/bin/bash というファイルがプログラムです。それ自体は何もせず、ただそこに存在しているだけです。料理に例えると、本棚に置かれたレシピ本です。
プロセス:実行中のプログラム
プロセスとは、プログラムをメモリに読み込んで、実際に実行している「生きている状態」のことです。OS がメモリや CPU 時間、開いているファイルなどのリソースを割り当てる単位でもあります。
レシピ本の例で言えば、調理台でシェフが実際に料理を作っている状態です。同じレシピ本(プログラム)から、複数の料理(プロセス)を同時に作ることもできます。
# 同じbashプログラムから複数のプロセスが起動している例
$ ps aux | grep bash
hirotano  4250  0.0  bash    # SSH接続1つ目のbash
hirotano  4163  0.0  bash    # GNOMEターミナルのbash
スレッド:プロセスの中の実行の流れ
スレッドとは、1つのプロセスの中にある「実行の流れ」のことです。1つのプロセスは複数のスレッドを持つことができ、スレッドどうしは同じメモリ空間や開いているファイルを共有しながら並行して動きます。
| 概念 | 場所 | 状態 | 単位 |
|---|---|---|---|
| プログラム | ディスク上 | 静的(動かない) | ファイル |
| プロセス | メモリ上 | 動的(実行中) | リソース管理の単位 |
| スレッド | プロセス内 | 動的(並行実行) | CPU で実行・スケジューリングされる単位 |
Linux カーネルの内部では、プロセスもスレッドも「タスク」として同じ構造体(後述の task_struct)で管理しています。スレッドは「メモリ空間などを共有するタスク」です。図1のように、最初のスレッドの ID(TID)はプロセスの PID と同じ番号になります。
プロセスのライフサイクル
プロセスは「生まれて、動いて、死ぬ」というサイクルを持っています。Linux カーネルは、各プロセスがいまどの状態にあるかを常に把握して管理しています。
プロセスの5つの状態
OS の教科書でよく使われる5つの状態で整理すると、次のようになります。各状態の下には、ps コマンドで見えるときの記号(STAT)を添えています。
| 状態 | 意味 |
|---|---|
| New(生成中) | プロセスが生まれようとしている瞬間。OS がメモリを確保し、管理情報を作っている |
| Ready(実行可能) | 実行の準備はできているが、CPU が空くのを待っている(順番待ち) |
| Running(実行中) | 実際に CPU で命令が処理されている。CPU コアが1つなら、同時に Running になれるのは1つだけ |
| Waiting(待機中) | ディスクの読み書きやネットワーク通信の完了、タイマーなどを待っている。この間 CPU は他のプロセスに使われる |
| Terminated(終了) | exit() で終了したが、親プロセスが wait() で回収するまで管理情報だけが残っている(ゾンビプロセス) |
- S(Interruptible Sleep):割り込み可能な待機。通常の I/O 待ちやキー入力待ち。シグナルで起こせる。
- D(Uninterruptible Sleep):割り込み不可の待機。カーネル内でディスクなどの I/O の完了を待っている。この間は
kill -9を送っても、I/O が終わるまで処理されない。
また、親が先に終了してしまった子プロセスは、PID 1(systemd)などが新しい親として引き取り、終了時に回収します。
実際の状態を確認してみる
# 全プロセスの状態を確認(STAT列に注目)
ps aux

# 出力例
USER       PID %CPU %MEM    VSZ   RSS TTY   STAT  CMD
hirotano  4250  0.0  0.0   6704  5392 pts/1 Ss    -bash
root         1  0.0  0.0 168368 11780 ?     Ss    /sbin/init
STAT 列の主な記号は次のとおりです。
| 記号 | 意味 |
|---|---|
| R | Running(実行中、または実行可能) |
| S | Sleeping(割り込み可能な待機) |
| D | Disk Sleep(割り込み不可の待機) |
| Z | Zombie(終了済みだが親が未回収) |
| T | Stopped(Ctrl+Z などで一時停止) |
| s | セッションリーダー(2文字目以降に付く) |
| + | フォアグラウンドのプロセスグループに属する |
出力例の bash は Ss なので、「入力待ちで眠っている(S)セッションリーダー(s)」です。教科書の Ready と Running は、Linux ではどちらも R と表示されます。
ユーザ空間とカーネル空間
CPU には「特権レベル」がある
CPU はすべての命令を同じ権限で実行しているわけではありません。Intel/AMD の x86 アーキテクチャには Ring 0〜Ring 3 という特権レベルがあり、Linux はこのうち Ring 0(カーネル)と Ring 3(ユーザ)の2つを使います。
なぜ2つに分けるのか
もしすべてのプログラムが Ring 0(特権モード)で動いていたら、悪意のあるプログラムやバグのあるプログラムが、OS 全体や他のプロセスのメモリを壊せてしまいます。ユーザ空間で動くプログラムができることを制限して、OS と他のプロセスを守っています。
システムコール:2つの世界をつなぐ橋
ユーザ空間のプログラムがファイルを読みたい、画面に出力したいときは、カーネルに「お願い」をする必要があります。このお願いの仕組みがシステムコールです。システムコールを呼ぶと CPU は Ring 3 から Ring 0 に切り替わり、カーネルが処理をしてから Ring 3 に戻ります。
strace コマンドを使うと、プログラムが発行するシステムコールをすべて観察できます。
# lsコマンドが発行するシステムコールを追う
strace ls 2>&1 | head -30

# 出力例(抜粋)
execve("/usr/bin/ls", ["ls"], 0x... /* 環境変数 */) = 0
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
read(3, "\177ELF\2\1\1\0\0..."..., 832) = 832
write(1, "file1  file2  file3\n", 20) = 20
| システムコール | していること | 戻り値 |
|---|---|---|
| execve | /usr/bin/ls を読み込み、同じ PID のまま中身を ls に置き換える | 0(成功) |
| openat | ライブラリの情報(/etc/ld.so.cache)を開く | 3(新しい fd の番号) |
| read | fd 3 から 832 バイト読む(先頭の \177ELF はバイナリの印) | 832(読んだバイト数) |
| write | fd 1(標準出力)にファイル名の一覧を書く | 20(書いたバイト数) |
ls のような単純なコマンドでも、内部では何十ものシステムコールが呼ばれています。
proc ファイルシステム
/proc とは何か
/proc は、ディスク上に実在するディレクトリではありません。Linux カーネルがメモリ上に作り出した仮想的なファイルシステムです。カーネルが管理しているプロセスの情報を、ファイルとして読める形で見せてくれます。/proc/[PID]/ というディレクトリが、各プロセスの「管理情報の窓口」です。
# bashのPIDを確認
$ echo $$
4250

# そのプロセスの/procディレクトリを見る
$ ls /proc/4250/
arch_status  cmdline  environ  fd  maps  mem  status  ...
task_struct:カーネルがプロセスを管理する構造体
Linux カーネルの内部では、各プロセスの情報を task_struct という C 言語の構造体で管理しています。/proc/[PID]/status は、その情報の主な部分を人間が読める形で表示したものです。
$ cat /proc/4250/status
実際の出力と、各フィールドの意味です。
Name:   bash              # プロセス名
State:  S (sleeping)      # 現在の状態(入力待ち)
Pid:    4250              # このプロセスのID
PPid:   4249              # 親プロセスのID(sshdプロセス)
Threads: 1                # スレッド数(bashはシングルスレッド)

VmSize:  6704 kB          # 仮想アドレス空間の合計
VmRSS:   5392 kB          # 実際に物理RAMに乗っている量

voluntary_ctxt_switches:     106   # 自らCPUを手放した回数
nonvoluntary_ctxt_switches:  192   # OSに強制的に切り替えられた回数
VmSize と VmRSS の違い
この2つは混同しやすいポイントです。
| 項目 | 意味 |
|---|---|
| VmSize | 仮想メモリサイズ。プロセスが「使うかもしれない」と確保した仮想アドレス空間の合計 |
| VmRSS | 物理メモリサイズ。実際に物理 RAM に載っている量(共有ライブラリの分も含む) |
VmSize > VmRSS なのが正常です。Linux は「実際に使われるまで物理メモリを割り当てない(遅延割り当て)」設計なので、確保だけされて実体のないページがあるためです。ps aux の VSZ と RSS も、この2つと同じ値です(出力例の 6704 と 5392)。
プロセスツリー:全プロセスは家族
すべてのプロセスは親子関係を持っています。pstree コマンドで確認してみます。
$ pstree -p
systemd(1)─┬─sshd(1262)───sshd(4176)───sshd(4249)───bash(4250)───pstree(6870)
           ├─NetworkManager(646)
           ...
SSH でログインしてコマンドを打つまでの流れが、そのまま見えています。
コマンドを打つたびに bash が子プロセスを作り、コマンドが終わると子プロセスは消えます。これが後半で解説する fork-exec の実例です。
/proc/[PID]/maps:メモリマップを覗く
$ cat /proc/4250/maps
出力を整理すると、プロセスの仮想アドレス空間の全体像が見えます。
アドレス範囲                      権限  内容
622bd09f4000-622bd0b55000         r-xp  /usr/bin/bash  ← コード(命令列)
622bd0b55000-622bd0b60000         rw-p  /usr/bin/bash  ← データ領域
622c062cc000-622c06416000         rw-p  [heap]         ← ヒープ(動的確保)
74d607800000-74d607a05000         r-xp  libc.so.6      ← 標準Cライブラリ
7fffb6184000-7fffb61a5000         rw-p  [stack]        ← スタック
これをアドレス空間のレイアウトとして図にすると、次のようになります。
ファイルディスクリプタ
「プロセスの口」という考え方
プロセスはファイルを読んだり、画面に出力したり、ネットワーク通信をしたりします。こうした「何かとつながっている口」を管理するために、Linux はファイルディスクリプタ(fd)という仕組みを使います。一言で言えば、「プロセスが何かにつながっている口に付けた番号」です。
Linux(Unix)は「すべてをファイルとして扱う」という考え方を持っています。通常のファイルだけでなく、端末、パイプ、ソケット、デバイスも、すべて fd という同じ仕組みで扱えます。
ファイルディスクリプタの3層構造
fd は単なる整数ですが、その裏にはカーネルが管理する実体があります。
fd はそのプロセスの中だけで意味を持つ番号です。「どのファイルにつながっているか」「どこまで読んだか」という情報は、カーネル側(②③)が持っています。
0、1、2 は予約済みの特別な番号
Unix の誕生のころからの約束事で、プロセスは通常、起動時に次の3つの fd を持っています。
| fd 番号 | 名前 | 役割 |
|---|---|---|
| 0 | stdin(標準入力) | キーボードからの入力など |
| 1 | stdout(標準出力) | 通常の出力先(画面など) |
| 2 | stderr(標準エラー出力) | エラーメッセージの出力先 |
bash で確認すると次のとおりです。
$ ls -la /proc/$$/fd
lrwx------ 0 -> /dev/pts/1   ← stdin  = SSH端末
lrwx------ 1 -> /dev/pts/1   ← stdout = SSH端末
lrwx------ 2 -> /dev/pts/1   ← stderr = SSH端末
lrwx------ 255 -> /dev/pts/1 ← bashの内部制御用
画面に文字が表示されるのは、printf が fd 1 に書き込み、それが SSH 端末(/dev/pts/1)につながっているからです。
fd の増減を観察する
# ファイルを開いてfdが増えるか確認
exec 3< /etc/hostname    # fd=3 で /etc/hostname を開く
ls -la /proc/$$/fd       # fd=3 が追加されているはず
cat <&3                  # fd=3 から読む
exec 3<&-                # fd=3 を閉じる
ls -la /proc/$$/fd       # fd=3 が消えているはず
実際の結果です。
# exec 3< /etc/hostname 後
lr-x------ 3 -> /etc/hostname   ← 追加された!読み取り専用(r)

# cat <&3 の結果
Ubuntu-1                         ← /etc/hostname の中身が読めた

# exec 3<&- 後
fd=3 が消えた                    ← 解放完了
この実験で確認できたことは次のとおりです。
| 操作の結果 | 確認できた概念 |
|---|---|
| fd 3 が出現した | 最小番号ルール(使用中の 0、1、2、255 を除いた最小の番号は 3) |
| lr-x と表示された | 開き方(読み取り/書き込み)がカーネルに記録される |
| cat <&3 で読めた | fd は「口の番号」で、中身はカーネルが管理している |
| fd 3 が消えた | close によるリソースの解放 |
リダイレクトの仕組み
Linux には「新しい fd には、空いている最小の番号を割り当てる」というルールがあります。ls > output.txt を実行すると、bash の子プロセスの中で、ls を起動する前に fd 1 のつながり先が output.txt に張り替えられます。
張り替えの方法は2通りで説明されます。
- 最小番号ルールを使う方法:
close(1)で fd 1 を空け、open("output.txt")すると、空いている最小の番号の 1 が割り当てられる(古典的な説明)。 - dup2 を使う方法:
open("output.txt")で別の番号を取り、dup2(その番号, 1)で fd 1 に複製してから元の番号を閉じる。実際の bash はこちらのやり方で張り替えている。
どちらの方法でも、ls のソースコードを変える必要はありません。「fd 1 に書く」という動作はそのままで、つながる先だけが変わっています。
パイプ ls | grep foo の仕組み
ls の stdout(fd 1)と grep の stdin(fd 0)が、カーネル内のパイプでつながっています。ls も grep も「fd 1 に書く」「fd 0 から読む」だけで、相手が誰かを知りません。
fork と exec
プロセスはどうやって生まれるか
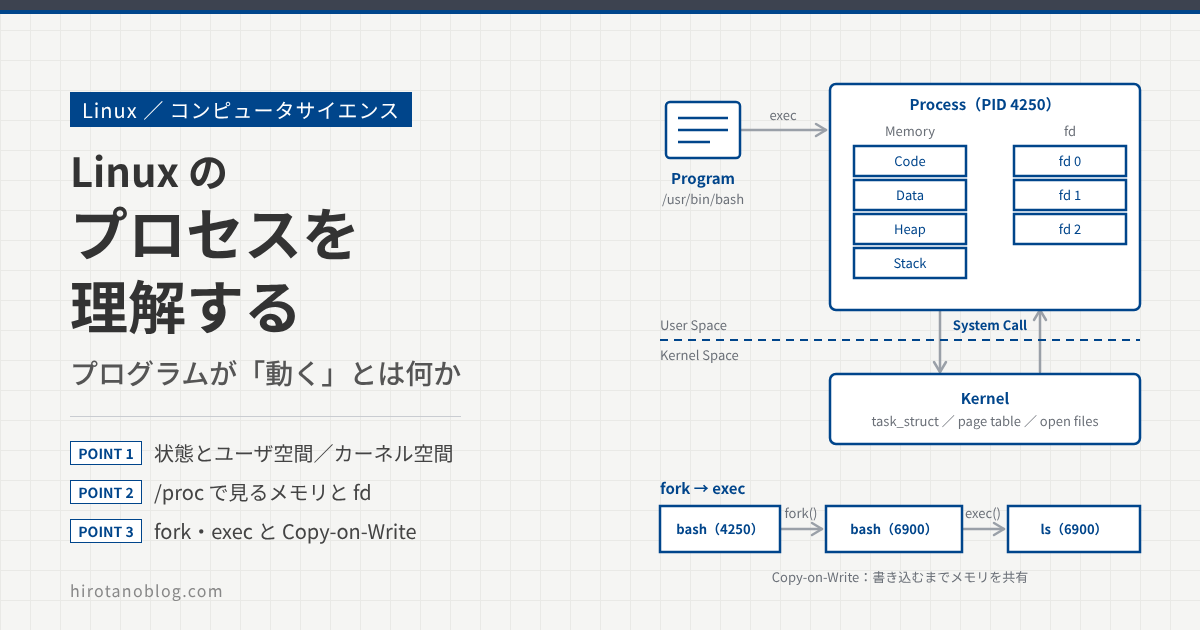
Linux で新しいプロセスを作るには、fork() と exec()(実際のシステムコールは execve())という2つのシステムコールを組み合わせます。bash が ls を実行するときの流れは次のとおりです。
fork():プロセスを「複製」する
fork() を呼ぶと、呼び出したプロセスのコピーが子プロセスとして作られます。親と子は fork() の戻り値で区別します。
pid_t pid = fork();

if (pid < 0) {
    // エラー
} else if (pid == 0) {
    // ここは子プロセスだけが通る(forkの戻り値が0)
    printf("私は子プロセス。PID=%d\n", getpid());
} else {
    // ここは親プロセスだけが通る(forkの戻り値が子のPID)
    printf("私は親プロセス。子のPID=%d\n", pid);
}
exec():プロセスを別のプログラムに置き換える
exec() を呼ぶと、現在のプロセスのメモリ(コード・データ・スタック)が、指定したプログラムの内容で丸ごと置き換えられます。
exec()を呼んでも PID は変わりません。中身だけが置き換わります。- 開いている fd は、そのまま新しいプログラムに引き継がれます(close-on-exec の印が付いた fd は除く)。リダイレクトやパイプが
exec()の後も効くのはこのためです。
なぜ fork と exec は分かれているのか
これは Unix の設計で特によく考えられた部分です。もし「新しいプログラムを起動する」1つの関数しかなかったら、子プロセスが実行を始める前に手を加える余地がありません。fork() と exec() の間のわずかな時間に、子プロセスは自分の環境を自由に準備できます。
| fork 後・exec 前にできること | 用途 |
|---|---|
| ファイルディスクリプタの張り替え | ls > file.txt などのリダイレクト |
| パイプの接続 | ls | grep foo などのパイプライン |
| 環境変数の変更 | 実行環境の調整 |
| nice 値の変更 | 優先度を下げてから実行 |
| シグナルマスクの設定 | 特定のシグナルの扱いを決める |
「小さな機能を組み合わせる」という Unix らしい考え方が、システムコールのレベルにも表れています。なお、生成と実行を1回で行う posix_spawn() も用意されており、用途によってはこちらが使われます。
pstree で見た SSH ログインの経路
systemd(1)
  └─sshd(1262)
      └─sshd(4176)
          └─sshd(4249)
              └─bash(4250)   ← あなたのシェル
                  └─pstree(6870)
この木構造は、すべて fork と exec の連鎖でできています(図5)。sshd(PID 1262)は接続が来るたびに fork() して子を作り、最後に fork() + exec(bash) でログインシェルが起動します。
Copy-on-Write
fork は本当に「コピー」しているのか
fork() はプロセスのコピーを作ると説明しました。しかし、たとえば 50MB のメモリを使っているプロセスを fork() のたびに丸ごとコピーしていたら、時間もメモリも大きく無駄になります。しかも fork-exec では、子はすぐに exec() で中身を捨ててしまうので、コピーしたメモリはほとんど使われません。
Linux はこの問題を Copy-on-Write(CoW)という仕組みで解決しています。
CoW の基本原理:「書き込むまでは共有する」
CoW が発動する仕組み
CoW は、カーネルと CPU のメモリ管理機構(MMU)が協調して動きます。
書き込みが起きるのは親でも子でも同じで、先に書き込んだ側にコピーが作られます。コピーされるのは書き込みのあったページ(通常 4KB 単位)だけで、ほかのページは引き続き共有されます。
C のコードで確認する
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>

int global_var = 100;  // 親子で共有されるデータ

int main() {
    printf("=== fork前 ===\n");
    printf("親: global_var = %d, アドレス = %p\n", global_var, &global_var);

    pid_t pid = fork();

    if (pid == 0) {
        // 子プロセス:書き込み前
        printf("\n=== 子プロセス(書き込み前) ===\n");
        printf("子: global_var = %d, アドレス = %p\n", global_var, &global_var);

        // 書き込み → ここでCoWが発動!
        global_var = 999;

        printf("\n=== 子プロセス(書き込み後) ===\n");
        printf("子: global_var = %d, アドレス = %p\n", global_var, &global_var);
        exit(0);
    } else {
        wait(NULL);
        printf("\n=== 親プロセス(子の終了後) ===\n");
        printf("親: global_var = %d, アドレス = %p\n", global_var, &global_var);
    }
    return 0;
}
$ gcc -o cow_demo cow_demo.c && ./cow_demo
実際の実行結果です。
=== fork前 ===
親: global_var = 100, アドレス = 0x5729856bd010

=== 子プロセス(書き込み前) ===
子: global_var = 100, アドレス = 0x5729856bd010

=== 子プロセス(書き込み後) ===
子: global_var = 999, アドレス = 0x5729856bd010   ← 値は変わった

=== 親プロセス(子の終了後) ===
親: global_var = 100, アドレス = 0x5729856bd010   ← 親は影響ゼロ!
この結果が示すこと
4行すべてで、仮想アドレスは 0x5729856bd010 と同じです。fork() は親のアドレス空間をそのまま複製するので、子でも同じアドレスに同じ変数があります。それでも値は独立しています。
「同じ仮想アドレスなのに値が違う」のは矛盾ではありません。仮想アドレスはプロセスごとに独立した「番地の体系」で、同じ番地でも、ページテーブルでつながる物理メモリが違えば別の場所を指します。現実の住所で例えると、次のようなイメージです。
東京都A区1丁目1番地 → 実際の土地A(親が持つ)
大阪府B区1丁目1番地 → 実際の土地B(子が持つ)

「1丁目1番地」という表記は同じでも、
都市(プロセス)が違えば別の場所を指す
CoW と fork-exec の組み合わせ
fork-exec では、CoW のおかげでメモリ本体のコピーがほぼ発生しません(ページテーブルの複製などは必要です)。新しいプロセスを作るコストが低いことは Unix/Linux の強みの1つで、シェルでコマンドを次々に実行できる理由でもあります。
実務でよく見る現象との関係
ここまでの仕組みを知っておくと、運用でよく出会う現象の意味がわかります。
| 現象 | 仕組みとの関係 | 確認すること |
|---|---|---|
| ゾンビ(Z)が増える | 親プロセスが wait() で子を回収していない | ps -o pid,ppid,stat,cmd で親を特定する |
| kill -9 で消えない | D 状態で I/O の完了を待っている | STAT が D か、ストレージや NFS の応答 |
| Too many open files | fd の上限に達した(閉じ忘れなど) | ls /proc/[PID]/fd | wc -l と ulimit -n |
| VSZ が大きすぎて見える | VSZ は確保しただけの仮想メモリ | 実際の使用量は RSS で見る |
まとめ
この記事で確認したことを整理します。
| 概念 | 確認方法 | 理解のポイント |
|---|---|---|
| プロセスの実体 | cat /proc/$$/status | task_struct の主な情報が見える |
| 状態 | ps aux の STAT 列 | R・S・D・Z・T で今の状態がわかる |
| システムコール | strace | ユーザ空間からカーネルへの依頼が見える |
| メモリレイアウト | cat /proc/$$/maps | 仮想アドレス空間の全体像 |
| ファイルディスクリプタ | ls -la /proc/$$/fd | プロセスの「口」が見える |
| fork-exec | pstree -p | 全プロセスの親子関係 |
| Copy-on-Write | C のコードでアドレスを比較 | 同じ仮想アドレス・別の物理ページ |
コメント