読む前にこの記事のポイントを音声で確認できます。この音声は本記事をもとにAIツール(NotebookLM)で自動生成したもので、発音や言い回しが不自然な箇所や、内容の誤りが含まれる可能性があります。理解の補助としてご利用ください。
前回の記事では、1 + 1 = 10₂ という1ビットの足し算が、XOR と AND の2つの論理ゲートだけでできることを見ました。今回はその続きで、桁上がりが次の桁に伝わっていく仕組みを扱います。
「3 + 1 = 4」という当たり前の足し算も、2 進数にすると桁上がりが2回続けて起きます。コンピューターは、その桁上がりを全加算器(Full Adder)という回路で次の桁へ受け渡しています。
この記事では、3 + 1 を例に、全加算器の仕組みと、全加算器をつないで複数桁を足すリップルキャリー加算器、さらにそれを速くするキャリー先読みの考え方までを説明します。
- 半加算器だけでは複数桁の足し算ができない理由
- 全加算器を半加算器2つと OR ゲートで作る仕組み
- 3 + 1 で桁上がりが伝わる様子と、リップルキャリーの弱点
まずは触ってみてください
文章で説明する前に、まずは動かしてみるのが早いと思うので、ブラウザ上で動く小さなシミュレーターを用意しました。
「次のゲートへ」ボタンを押すたびに、HA1(青)→ HA2(橙)→ OR(ピンク)の3つのブロックが順番に光り、配線をキャリー信号が流れていきます。9回押すと、3 + 1 = 4 が回路の中で完成するまでを最後まで追えます。
| ブロック | 役割 |
|---|---|
| HA1 | 1個目の半加算器。A XOR B と A AND B を計算する |
| HA2 | 2個目の半加算器。前の桁からのキャリーを足し込む |
| OR | 2つのキャリー候補をまとめて、次の桁へ送る |
下位の FA0 から上位の FA2 へ、キャリー(繰り上がり)が順番にリレーしていく様子が分かると思います。「全加算器は、なぜ半加算器2個と OR で足し算できるのか」を体感してから本編に進むと、理屈がすっと入ってきます。
はじめに ── 半加算器には弱点がある
前回の半加算器(Half Adder)は、A と B の2つの入力ビットを受け取り、SUM と CARRY を出力する回路でした。
| A | B | SUM | CARRY |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
1 + 1 のときだけ桁が上がって CARRY = 1 が出ます。では、出てきた CARRY = 1 はどこへ行くのでしょうか。半加算器は CARRY を出力するだけで、前の桁からの CARRY を受け取る入力がありません。これが「半(Half)」加算器と呼ばれる理由です。3 + 1 のような複数桁の足し算をしようとすると、この弱点が問題になります。
3 + 1 を 2 進数で筆算してみる
10 進数の 3 + 1 = 4 を、2 進数で書き直してみます。
   011    (= 3)
 + 001    (= 1)
 -----
   100    (= 4)
小学校で習った筆算と同じ手順で、右の桁から順に足していきます。
第0桁(一番右)
  1
+ 1
---
 10  ← ここで桁が上がる!
1 + 1 = 10₂ です。この桁の答えは 0 で、1 は左隣の桁に繰り上がります。これが「キャリー(carry)」、繰り上がりです。
第1桁(真ん中)
ここがポイントです。この桁では、足す数が3つあります。
| 足すもの | 値 |
|---|---|
| A の第1桁 | 1 |
| B の第1桁 | 0 |
| 第0桁からの繰り上がり | 1 |
つまり 1 + 0 + 1 = 10₂ で、再び桁上がりが起きます。
第2桁(一番左)
| 足すもの | 値 |
|---|---|
| A の第2桁 | 0 |
| B の第2桁 | 0 |
| 第1桁からの繰り上がり | 1 |
0 + 0 + 1 = 1 で、今度は桁上がりがありません。結果を並べると 100₂ = 4 になり、正しく計算できました。
半加算器では足りない理由
筆算からわかるように、2桁目以降の足し算では、ビットを3つ足す必要があります。ところが半加算器の入力は A と B の2つだけで、繰り上がりを受け取る入口がありません。そこで使うのが全加算器(Full Adder)です。
| 種類 | 入力 | 出力 |
|---|---|---|
| 半加算器 | A、B | SUM、CARRY |
| 全加算器 | A、B、C_in(前の桁からの繰り上がり) | SUM、C_out(次の桁への繰り上がり) |
入力に C_in(キャリーイン)、出力に C_out(キャリーアウト)が増えただけです。これだけで、全加算器をつないでいけば、何桁の足し算でもできるようになります。
全加算器の真理値表
入力が3つになったので、組み合わせは 2³ = 8 通りです。
| A | B | C_in | SUM | C_out | 意味 |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 + 0 + 0 = 0 |
| 0 | 0 | 1 | 1 | 0 | 0 + 0 + 1 = 1 |
| 0 | 1 | 0 | 1 | 0 | 0 + 1 + 0 = 1 |
| 0 | 1 | 1 | 0 | 1 | 0 + 1 + 1 = 10₂ |
| 1 | 0 | 0 | 1 | 0 | 1 + 0 + 0 = 1 |
| 1 | 0 | 1 | 0 | 1 | 1 + 0 + 1 = 10₂ |
| 1 | 1 | 0 | 0 | 1 | 1 + 1 + 0 = 10₂ |
| 1 | 1 | 1 | 1 | 1 | 1 + 1 + 1 = 11₂ |
この表には、注目してほしいパターンが2つあります。
| 出力 | パターン | 論理ゲートでの表し方 |
|---|---|---|
| SUM | 3つの入力のうち、1 の数が奇数個のときだけ 1 | 3入力の XOR(A XOR B XOR C_in) |
| C_out | 3つの入力のうち、1 の数が2個以上のときに 1(多数決) | 2入力ずつの AND を3つ作り、OR でまとめる((A AND B) OR (B AND C_in) OR (A AND C_in)) |
全加算器を半加算器2個で作る
ここからが面白いところです。全加算器は、半加算器を2つと OR ゲートを1つ組み合わせて作れます。
| 順番 | 部品 | やっていること |
|---|---|---|
| 1 | HA1(1個目の半加算器) | A と B を足して、途中結果 S1 と C1 を出す |
| 2 | HA2(2個目の半加算器) | S1 と C_in(前の桁からの繰り上がり)を足して、最終的な SUM と C2 を出す |
| 3 | OR ゲート | C1 か C2 のどちらかが 1 なら、C_out を 1 にする |
C1 と C2 が同時に 1 になることはないからです。C1 = 1 になるのは A = B = 1 のときで、このとき S1 は 0 なので、HA2 で S1 と C_in を足しても桁上がり(C2)は起きません。逆に C2 = 1 になるのは S1 = 1 のときで、このとき A と B のどちらか一方だけが 1 なので C1 は 0 です。どちらかの C が立っていれば、その桁は繰り上がる、と考えれば十分です。
論理式で書くと、次のようになります。
SUM   = A XOR B XOR C_in
C_out = (A AND B) OR ((A XOR B) AND C_in)
たった2行で、桁上がりを受け継ぎながら足し算する回路の本質が表せます。ゲートの数で数えると、全加算器1個は XOR 2つ、AND 2つ、OR 1つの5個です。
3 + 1 を全加算器で計算してみる
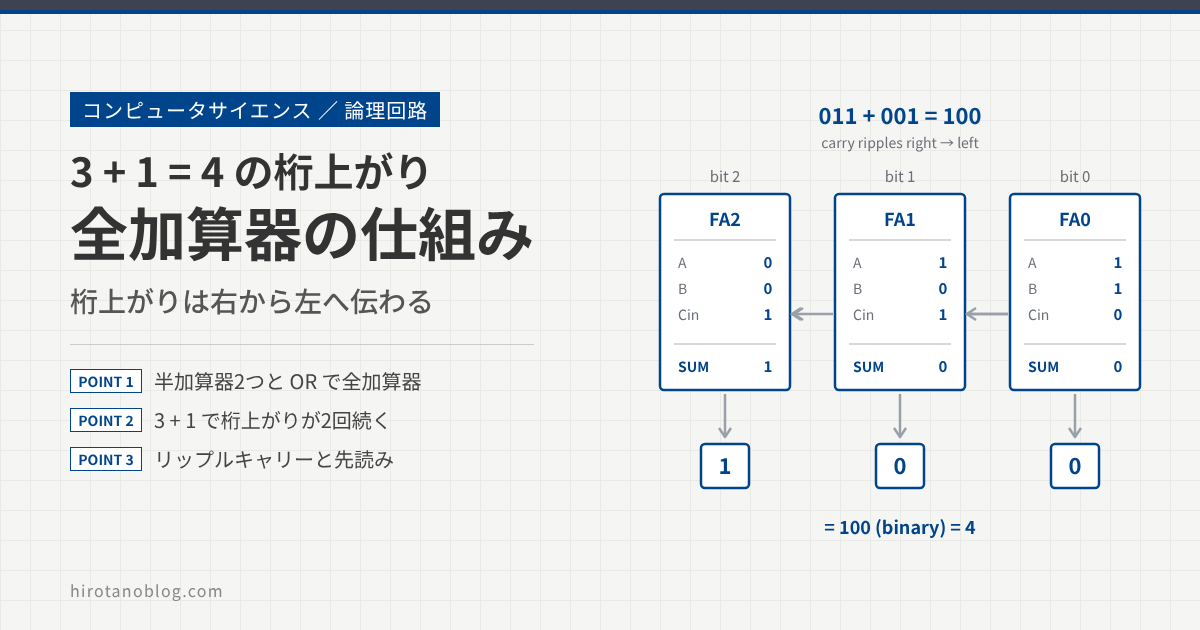
3ビットの加算器を作るには、全加算器を3個つなぎます(ゲートにすると15個です)。右の FA0 から順に、桁上がりが左へ伝わっていきます。
FA0(一番右の桁)
入力は A = 1、B = 1、C_in = 0 です。1 + 1 + 0 = 10₂ なので、SUM = 0、C_out = 1 になります。桁上がりが起き、C_out = 1 が左隣の FA1 の C_in に流れ込みます。
FA1(真ん中の桁)
FA1 の出力は、FA0 からの C_in = 1 が届くまで確定しません。信号がゲートを通るのにかかる時間をゲート遅延(伝搬遅延)と呼び、桁上がりの待ち時間は加算器の速さを決める大きな要因になります。
入力は A = 1、B = 0、C_in = 1 です。1 + 0 + 1 = 10₂ なので、SUM = 0、C_out = 1 になります。また桁上がりが起き、C_out = 1 が FA2 に流れます。
FA2(一番左の桁)
入力は A = 0、B = 0、C_in = 1 です。0 + 0 + 1 = 1 なので、SUM = 1、C_out = 0 になり、ここで桁上がりが止まります。
| 全加算器 | A | B | C_in | SUM | C_out |
|---|---|---|---|---|---|
| FA0(第0桁) | 1 | 1 | 0 | 0 | 1 |
| FA1(第1桁) | 1 | 0 | 1 | 0 | 1 |
| FA2(第2桁) | 0 | 0 | 1 | 1 | 0 |
第2桁から第0桁の SUM を並べると 100₂ = 4 です。電気信号だけで、筆算と同じことをしています。
なぜ「リップルキャリー(Ripple Carry)」と呼ばれるのか
3 + 1 の例で見たように、繰り上がりは右から左へ、波(ripple)のように順番に伝わっていきます。これがリップルキャリー加算器(Ripple Carry Adder)という名前の由来です。シンプルな設計ですが、桁数が増えると、計算が終わるまでの時間が桁数に比例して長くなるという欠点があります。
64 ビットの足し算では、最悪の場合、第0桁で生まれたキャリーが第63桁まで、64個の全加算器を順に通っていきます。全加算器1個あたりキャリーはゲート2段分(AND と OR)遅れるので、全体では100段を超えるゲートを待つことになります。
速くする工夫 ── キャリー先読み
そこで高速な加算器では、キャリー先読み(Carry Lookahead)という考え方を使います。各桁について、次の2つの信号を先に求めておきます。
| 信号 | 求め方 | 意味 |
|---|---|---|
| 生成(Generate) | A AND B | C_in に関係なく、この桁で必ず桁上がりが起きる |
| 伝搬(Propagate) | A XOR B | C_in が 1 なら、その桁上がりを次の桁へそのまま渡す |
各桁の C_out は「生成が 1、または伝搬が 1 で C_in も 1」と表せます。この式を下の桁から順に展開すると、どの桁の C_out も、各桁の生成・伝搬と最初の C_in だけで表せます。そのため、前の桁の結果を待たずに、全部の桁のキャリーを並列に計算できます。コッゲ・ストーン加算器などの並列プレフィックス加算器では、キャリーを求める段数を、桁数ではなく桁数の対数程度に抑えられます。
ただし、回路は複雑になり、ゲート(トランジスタ)の数は増えます。速さと回路の規模のどちらを取るか、CPU の設計はこうしたトレードオフの積み重ねです。
まとめ ── 「+」記号の中身
ここまでで、a + b という何気ない式の中で何が起きているかを、回路のレベルで追いかけてきました。
| 項目 | ポイント |
|---|---|
| 半加算器 | 1ビットの足し算を XOR と AND で行う。前の桁からの桁上がりを受け取れない |
| 全加算器 | A、B、C_in の3ビットを足す。半加算器2個と OR ゲートで作れる |
| リップルキャリー加算器 | 全加算器を並べて C_out を次の C_in につなぐと、何ビットの足し算もできる |
| リップルキャリーの弱点 | キャリーが順番に伝わるので、桁数に比例して遅くなる |
| キャリー先読み | 生成と伝搬の信号から全部の桁のキャリーを並列に求め、高速にする(回路は大きくなる) |
プログラムで 3 + 1 と書いたとき、CPU の中ではこれだけのことが、1 ナノ秒にも満たない時間で起きています。数を足すという、人類が何千年も続けてきた行為を、電気信号と論理ゲートの組み合わせで再現できる。コンピューターがコンピューターである理由は、ここにあると私は思っています。
次は、引き算がどう実現されているかを見ていく予定です。2 の補数を使うと、足し算の回路に少し手を加えるだけで、引き算にも使えます。
コメント