システムエンジニア(SE)の仕事と切っても切り離せないのが、突然起こるシステム障害です。利用者から「システムが使えない」という申告が集まり、SE はシステム部門(お客様)から最優先での対応を求められます。
この記事では、システム障害が起きたときに SE がどう動けばよいかを、ネットワークエンジニアである筆者の経験からまとめます。コマンドや調査手法の話ではなく、障害対応の進め方とお客様への報告の仕方が中心です。
- 最初にお客様へ確認する3つのこと(状況・発生時間・作業の有無)
- 調査・原因究明・復旧の各段階で、お客様へ伝えること
- 復旧後の報告と、人を責めない再発防止の考え方
- 被疑機器を再起動する前に考えること
障害対応の流れ
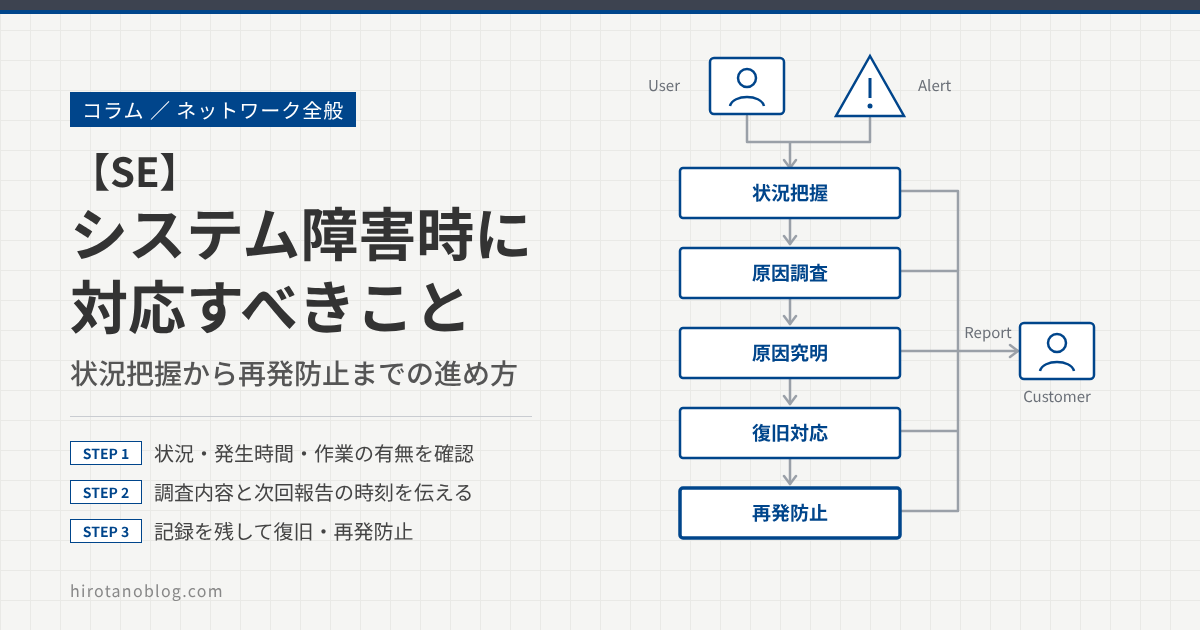
障害対応は、大きく5つの段階で進みます。どの段階でも、SE だけで抱え込まず、お客様へ状況を報告し、次の動きについて了承をもらいながら進めるのがポイントです。
障害状況の把握
障害対応というと、トラブルシューティングの手法など技術的な面に目が向きがちです。ただ、いきなりネットワーク機器のエラーログやデバッグの確認から始めると、どこを見るべきかが絞れず、結果として解決までに時間がかかります。
まずは障害の状況を把握します。最低でも、次の3点をお客様に確認します。
| 確認すること | 内容 |
|---|---|
| 状況 | 何ができて、何ができないのかを見極めます。障害の切り分けの出発点になります。あわせて、障害による影響を次の2つの観点で確認します。 ・システム観点:日次処理ができない、など ・利用者観点:影響を受けた利用者の範囲(社内ユーザだけか、一般ユーザにも影響があるか)と、おおよそのユーザ数 |
| 発生時間 | 利用者からいつ申告があったかを確認します。システム監視のアラート通知があれば、その時刻もあわせて確認します。 |
| 作業の有無 | 障害が起きる前に、何か作業をしていないかを確認します。例えば、スイッチや端末の増設、ファイアウォールの設定変更などです。 |
影響の情報は、障害が解決したあとにトラブルレポート(報告書)を出すときにも必要になります。最初に聞いておくと、あとで慌てずに済みます。
作業の有無は特に大事です。作業をした人も、まさかその作業が原因で障害が起きるとは思っていません。どんなに軽微なものでも、関係がなさそうなものでも確認します。「そういえば、その時間帯に〜をした」とわかるだけで解決するケースもあります。
「何ができないか」は、次のように分けて聞くと、原因の場所を絞り込みやすくなります。
- 場所:特定の拠点やフロアだけか、全拠点か
- 相手:特定のサーバやアプリケーションだけか、すべてか
- 人:特定の利用者だけか、全員か
また、複数の機器のログを発生時間で突き合わせるには、各機器の時刻が合っている必要があります。日ごろから NTP で時刻をそろえておくと、障害時の調査が楽になります。
障害原因の調査
障害の状況がおおよそ把握できたら、原因の調査を始めます。調査の方法は、発生状況やシステムによって変わります。ただ、方法が何であっても、お客様には次の3点を必ず報告します。
| 報告すること | 内容 |
|---|---|
| 調査の内容 | 何を調査するのかと、その所要時間の目安。 |
| 調査による影響 | 調査することで、ほかに影響が出るかどうか。例えば、調査のためのコマンドを実行すると、機器の処理負荷が上がる場合があります。 |
| 次回報告のタイミング | 次にいつ調査状況を報告するか。 |
3つめの次回報告のタイミングは、特に大事です。お客様は先が見えないことに不安を感じます。原因がまだわからなくても、「次は○時に状況を報告します」とあらかじめ宣言しておきましょう。
Cisco の機器では、debug コマンドの出力はほかの処理より優先して扱われます。負荷が高いときに出力の多いデバッグを有効にすると、機器の動作に影響が出たり、最悪の場合は応答しなくなったりします。デバッグを使う前には CPU 使用率に余裕があるかを確認し、影響の可能性をお客様に伝えたうえで実行します。
原因の究明と対応案
原因がわかったら、お客様に次の2点を必ず報告します。
| 報告すること | 内容 |
|---|---|
| 障害原因 | 調査の結果と、障害の発生原因を報告します。原因に少しでも推測が含まれる場合は、どこまでが確認できた事実で、どこからが推測かを必ず伝えます。 |
| 対応案 | 障害の復旧に向けた対応案を示します。その対応を実施した場合のシステムや利用者への影響と所要時間もあわせて伝え、お客様から対応の許可をもらいます。 |
対応案は、すぐにサービスを戻すための暫定対処と、原因そのものをなくす恒久対策に分けて示すと、お客様が判断しやすくなります。また、設定変更を伴う場合は、変更前の設定を保存し、うまくいかなかったときに元へ戻す手順(切り戻し手順)も用意しておきます。
復旧に向けた対応
お客様の許可を得てから、対応を実施します。
対応するときは、いつ、何をしたかを必ず記録します。障害が解決したあと、トラブルレポートで対応の経緯を報告することがあるためです。記録は、あとから時系列で並べられるように残しておきます。
| 記録すること | 例 |
|---|---|
| 時刻 | 作業を始めた時刻、終えた時刻 |
| 実施者 | 誰が作業したか |
| 作業内容 | 実行したコマンドや変更した設定 |
| 結果 | 作業のあとに何が変わったか、変わらなかったか |
対応中も、お客様には定期的に進捗を報告します。
対応が終わったら、障害が復旧しているかをお客様に確認してもらいます。復旧のための対応で、障害が起きた箇所以外に影響が出ていないかも確かめる必要があるので、できる範囲で業務全体の確認をお願いします。
障害復旧後
復旧したら、まずお客様へ速報として、経緯、原因、対応を報告します。そのうえで、お客様からトラブルレポート(報告書)を求められることもあります。
| 報告書に入れる内容 | 中身 |
|---|---|
| 発生日時・影響 | いつ発生し、どのシステム・利用者にどんな影響があったか(STEP 1 で確認した内容) |
| 経緯 | 申告から復旧までに何をしたか(STEP 4 の記録を時系列に並べたもの) |
| 原因・対応 | 障害の原因と、実施した対応 |
| 再発防止策 | 同じ障害を起こさないための対策 |
あわせて、同じ原因で障害が再び起きないよう、再発防止策を検討します。人為的なミスが原因だった場合も、作業した人を責めるのではなく、ミスが起きにくい仕組みを建設的に考えます。個人を責めると、次に問題が起きたときに報告や作業内容の共有がためらわれ、かえって原因調査が難しくなるためです。
番外編:被疑機器を再起動するとき
復旧が最優先という場面も多く、被疑となる機器を再起動して挙動が変わるかを確認することがあります。
その場合は、まず機器の再起動による影響(通信断の発生、ログの消失など)を洗い出します。また、再起動で復旧したとしても、そのあと原因調査ができなくなる場合があります。お客様にこのリスクを十分に理解してもらったうえで、作業を実施するようにしましょう。
Cisco のルータでは、ログ(警告やエラー、デバッグの出力など)は通常、機器のメモリ(DRAM)上のバッファに保存されます。DRAM の内容は再起動で消えるため、再起動の前に、時間が許す範囲でログや機器の状態を表示して保存しておきます。
日ごろの備えとしては、ログを Syslog サーバへ転送しておく方法や、logging persistent でフラッシュにログを書き出しておく方法があります。どちらも再起動のあとにログが残るので、再起動前の状況をあとから調べられます。
まとめ
| 段階 | やること・お客様に伝えること |
|---|---|
| 障害状況の把握 | 状況(システム観点・利用者観点)、発生時間、作業の有無を確認する |
| 原因の調査 | 調査の内容と所要時間、調査による影響、次回報告のタイミングを伝える |
| 原因の究明 | 原因(推測の有無を含む)と、影響・所要時間つきの対応案を伝え、許可をもらう |
| 復旧対応 | いつ何をしたかを記録し、進捗を報告する。復旧後は業務全体の確認を依頼する |
| 復旧後 | 速報と報告書で経緯・原因・対応を伝え、人を責めない再発防止策を考える |
| 再起動するとき | 影響とログの消失を洗い出し、リスクをお客様に理解してもらってから実施する |
障害対応では技術力ももちろん必要ですが、それと同じくらい、状況を正しくつかみ、お客様に先の見通しを伝え続けることが大切です。
コメント